07-17 下午:强化学习、多智能体与具身智能
阅读提示
强化学习中应区分环境状态、观测、动作、奖励、策略、价值函数和轨迹。算法推导依赖 MDP 与数据采样假设。基础定义可对照 Sutton 与 Barto,环境接口可对照 Gymnasium 文档。11 12
强化学习研究带反馈的连续决策。监督学习通常直接给出输入和目标输出;强化学习中的动作会改变之后会看到的状态,奖励也可能在多步以后才出现。智能体必须在已经有效的行为和还没有充分尝试的行为之间分配采样。后文会依次讨论价值估计、经验复用、多智能体、规划和机器人部署。
以 3×3 网格为例,机器人从左下角走到右上角。状态(state)可写成坐标 \((x,y)\)。动作(action)包括上、下、左、右。每走一步的奖励(reward)为 \(-1\),到达目标的奖励为 \(10\)。策略(policy)给出每个状态下各动作的选择概率,例如在起点以 0.7 的概率向右、0.2 向上、0.1 向下。强化学习优化长期累计奖励。
监督学习会为每个状态提供教师动作,机器人可直接学习模仿。强化学习只看到动作后的奖励,错误的后果可能在很多步以后才显现。回报(return)是从某一时刻开始累计的奖励,通常带折扣。交互数据与延迟反馈由此带来探索和价值估计问题。
一次强化学习交互怎样形成训练数据
环境在时刻 \(t\) 提供状态或观测 \(s_t\)。机器人中它可以是位置、图像、速度和传感器数据。游戏中可以是棋盘或屏幕。观测必须包含做出合理决策所需的信息,或由历史窗口、状态估计补足。
策略 \(\pi(a\mid s)\) 根据当前观测输出动作或动作概率。离散动作可以是上、下、左、右。连续动作可以是关节速度、力或控制量。
环境执行动作后产生奖励 \(r_{t+1}\)、下一状态 \(s_{t+1}\),并标记任务是否终止。状态、动作、奖励、下一状态和终止标记构成一条 transition,即一次可用于训练的交互记录。
多条 transition 按时间组成轨迹。价值方法用轨迹估计回报和价值。策略梯度方法用动作概率与优势更新策略。经验回放方法还会保存历史 transition 供后续采样。
Sutton 与 Barto 对强化学习的概括(译)
强化学习研究学习系统如何通过与环境交互来最大化累计奖励。学习者并不直接得到每一步的正确动作,而是需要在延迟奖励和自身行为改变数据分布的条件下改进决策。11
强化学习的基本问题
从定义开始学习强化学习
强化学习研究智能体怎样依据交互经验改进策略。Sutton 与 Barto 的教材通常用马尔可夫决策过程(Markov decision process,MDP)统一表述:环境在状态 \(s\) 接收动作 \(a\),按照转移分布产生后继状态和奖励;策略在任务规定的时间范围和折扣下最大化期望回报。MDP 是一种建模假设。现实问题中的历史信息可以放入状态、历史窗口或状态估计中。11
强化学习的数据分布会受到当前策略影响。策略改变后,随后收集到的状态、动作和奖励也会变化。奖励还可能延迟出现。因此,算法需要同时处理探索、估计误差、样本效率和训练稳定性。on-policy、off-policy、价值方法和策略梯度方法处理这些问题的方式不同。
在工程系统中,先明确环境接口、观测与状态的区别、动作空间、终止条件、奖励标度和评估指标。奖励函数应表达实际约束,并单独保存评估轨迹与随机种子。训练回报上升后,还要检查策略在未见初始状态或扰动下是否可靠。12
强化学习问题定义
在时刻 \(t\),智能体观察状态或观测 \(s_t\),按策略选择动作 \(a_t\)。环境产生下一个状态 \(s_{t+1}\) 和奖励 \(r_{t+1}\)。按时间顺序记录的状态、动作和奖励构成一条轨迹(trajectory)。
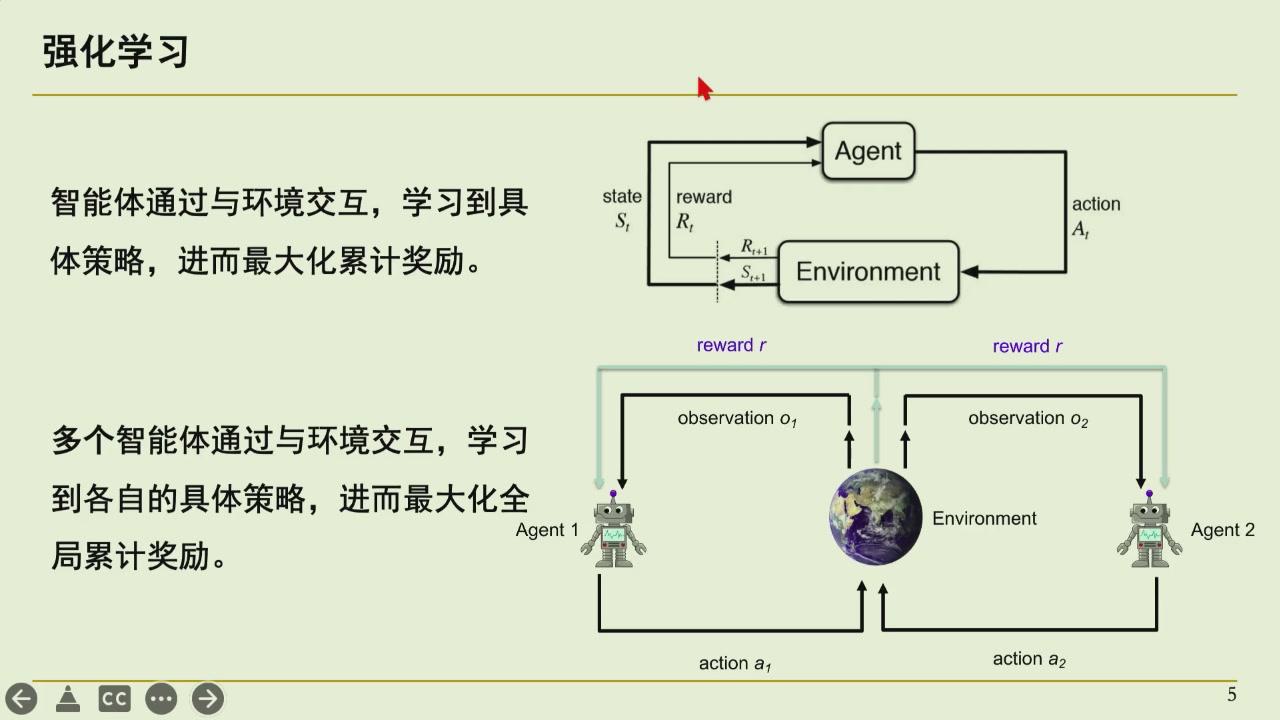
每次交互产生状态、动作、奖励和后继状态。这些记录可用于价值估计或策略更新。
| 记号 | 含义 | 由谁产生 |
|---|---|---|
| \(s_t\) | 时刻 \(t\) 的状态或观测 | 环境/传感器 |
| \(a_t\) | 智能体选择的动作 | 策略 |
| \(r_{t+1}\) | 执行动作后的即时奖励 | 环境与奖励函数 |
| \(\pi(a\mid s)\) | 在状态下选择动作的概率 | 待学习策略 |
| \(\gamma\) | 未来奖励的折扣系数 | 任务设计者 |
策略记为 \(\pi(a\mid s)\),表示处于状态 \(s\) 时选择各动作的概率。学习目标是让之后的折扣回报期望最大,单步奖励只是这个总和中的一项。
其中 \(0\leq\gamma\leq1\) 是折扣因子。\(\gamma\) 小时,智能体更在意近处反馈。接近 1 时,它会为较远的结果安排动作。奖励设计决定它实际学什么。只奖励尽快到达时,机器人可能学到不安全的快动作。只罚能耗时,它又可能完全不动。奖励函数本身就是任务目标的一部分。
用网格世界算一条回报。设轨迹为
(0,0) --右--> (1,0) --右--> (2,0) --上--> (2,1) --上--> (2,2)
奖励         -1            -1            -1           -1            +10
若 \(\gamma=0.9\),从起点看的折扣回报为
同一个任务换成 \(\gamma=0.5\),终点奖励只折成 \(0.5^4\times10=0.625\),四个 \(-1\) 的惩罚反而更突出,策略可能变得非常保守。折扣因子既影响数值尺度,也影响任务偏好。
回报自测
三步奖励为 \([1,0,10]\),折扣因子 \(\gamma=0.8\)。计算 \(G_0\)、\(G_1\) 和 \(G_2\)。
从后往前递推最方便。
G2 = 10
G1 = 0 + 0.8×10 = 8
G0 = 1 + 0.8×8 = 7.4
这个递推就是 \(G_t=r_{t+1}+\gamma G_{t+1}\),也是后面贝尔曼方程的出发点。
状态需要包含对决策有用的信息。同一个观测在不同历史下应采取不同动作时,只把当前观测当状态会丢失关键信息。这时可加入历史窗口、递归网络或显式的环境状态估计。经典马尔可夫决策过程(MDP)假定当前状态已经足以决定下一步的转移和奖励分布。
左侧表示在当前状态 \(s_t\) 执行动作 \(a_t\) 后,得到下一状态 \(s_{t+1}\) 和奖励 \(r_{t+1}\) 的联合概率分布。马尔可夫假设要求这个分布只依赖当前状态和动作,而不再显式依赖更早历史。
它是一个建模假设,不是说现实世界没有历史。
折扣因子改变了什么
两条路径的即时奖励分别为 1 和 0;后一条在 10 步后额外得到 100。若 \(\gamma=0.9\),远期回报折为约 34.9,后一条仍优;若 \(\gamma=0.5\),只剩约 0.098,策略会偏向即时奖励。折扣同时表达任务偏好,并控制无限期回报的数值尺度。
思考题
MDP 的马尔可夫性要求什么?它为什么不是说现实世界没有历史?
答案
它要求当前状态已经包含决定下一步转移和奖励所需的信息。若历史仍影响结果,可以把相关历史并入状态,用记忆网络或状态估计补足。马尔可夫性是建模选择,现实系统可以带着历史信息去满足它。
思考题
折扣因子 \(\gamma\) 从 0.90 调到 0.99,策略会更重视眼前奖励还是长期奖励?可能带来什么代价?
答案
更接近 1 的折扣因子让远处奖励在当前价值中衰减更慢,策略更重视长期后果。代价是有效时间跨度变长,估计方差更大,训练也需要覆盖更长的轨迹。若环境会在近期终止,过大的 \(\gamma\) 对结果影响有限。
价值函数
策略价值函数 \(V^\pi(s)\) 表示从状态 \(s\) 出发、之后按策略 \(\pi\) 行动能得到的期望回报。动作价值函数 \(Q^\pi(s,a)\) 把当前动作也固定下来,先做 \(a\),再按 \(\pi\) 行动。选择动作时,有了 \(Q\) 就可以偏向值更大的动作。
给两个假想的估计值,就能看清 \(V\) 与 \(Q\) 的关系。设在状态 \(s_1\),向右一步奖励为 \(-1\),到达 \(s_2\);向上一步奖励为 \(-1\),到达 \(s_3\)。若 \(V^\pi(s_2)=6\)、\(V^\pi(s_3)=4\)、\(\gamma=0.9\),则
若策略在 \(s_1\) 以 0.7 选右、0.3 选上,则 \(V^\pi(s_1)=0.7\times4.4+0.3\times2.6=3.86\)。价值函数用一个期望值概括未来可能发生的动作和奖励,方便将长轨迹写成可递推的学习目标。
贝尔曼关系把长期回报拆成一步奖励与后续价值。
\(Q^\pi(s_t,a_t)\) 是在时刻 \(t\) 先执行动作 \(a_t\)、之后按策略 \(\pi\) 行动的动作价值;\(r_{t+1}\) 是这一步奖励,\(V^\pi(s_{t+1})\) 是到达下一状态后的策略价值。期望符号表示环境转移和后续动作可能带有随机性。
贝尔曼关系提供了可递推估计的目标。值函数近似、策略梯度、actor-critic 等方法分别用不同参数化和更新方式处理它。
真实任务常把状态、动作和策略交给神经网络表示。网络带来表达能力,也带来不稳定性。采样数据相关、奖励有噪声、目标随着策略更新不断变化,都会使训练曲线波动。
思考题
为什么状态价值函数和动作价值函数可以互补?如果只有 \(Q(s,a)\),选择动作时可以怎么用?
答案
状态价值 \(V(s)\) 评估从状态出发、之后按某策略行动的期望回报,动作价值 \(Q(s,a)\) 固定当前动作再评估。只有 \(Q\) 时,可以直接比较当前状态下各动作的 \(Q\),偏向值更大的动作。\(V\) 常作为 baseline 或 critic 的一部分,\(Q\) 更直接用于动作选择。
思考题
目标网络(target network)为什么不与预测网络在每一步使用完全相同的参数?
答案
TD 目标里包含下一状态的价值估计。若同一个网络同时给出预测和目标,参数更新会追着不断变化的目标走,形成容易发散的反馈。target network(目标网络,即预测网络的一份滞后参数副本)在一段时间内保持旧参数,让目标相对稳定,再通过硬更新或滑动平均逐渐跟随训练网络。
蒙特卡洛、时间差分与 \(\lambda\)
一条轨迹结束后,可以直接把实际得到的 \(G_t\) 当作状态或状态动作对的学习目标。这是蒙特卡洛(MC)思想。它不需要估计下一状态价值,但必须等到后续回报出现;长任务中方差也可能很大。
时间差分(TD)可以在整条轨迹结束前更新。最简单的一步 TD target 是
\(y_t\) 是用来更新当前价值估计的学习目标。它由已经观察到的即时奖励 \(r_{t+1}\) 和对下一状态价值的当前估计组成。
或在 Q-learning 里使用 \(r_{t+1}+\gamma\max_aQ(s_{t+1},a)\)。它用当前估计的下一状态价值来更新当前价值,叫 bootstrapping。代价是目标也依赖自己的估计,估计误差会被带入更新。
设一条简单轨迹的奖励为 \([0,0,10]\),\(\gamma=0.9\)。蒙特卡洛必须等轨迹结束,然后得到
G_2=10
G_1=0+0.9×10=9
G_0=0+0.9×9=8.1
这些完整回报就是 MC 的学习目标。若采用一步 TD,并且当前估计 \(V(s_2)=9\),那么在刚观察到 \(s_0\to s_1\)、奖励为 0 时,目标已经是
如果 \(V(s_1)\) 暂时用 8 估计,目标就是 7.2。TD 不必等到终点,但 8 这个估计可能不准,误差会传入新的目标。MC 偏差小、方差大;TD 更快、方差低,却依赖自举。
TD(\(\lambda\)) 在 MC 与一步 TD 之间插值。较小的 \(\lambda\) 更接近短步自举,更新快但目标偏差更多。较大的 \(\lambda\) 利用更长的真实轨迹,接近 MC,方差也更大。环境、策略阶段和数据分布变化后,同一个 \(\lambda\) 未必仍然合适。实际实现应将它与 rollout 长度、优势估计和数据新鲜度一起验证。3
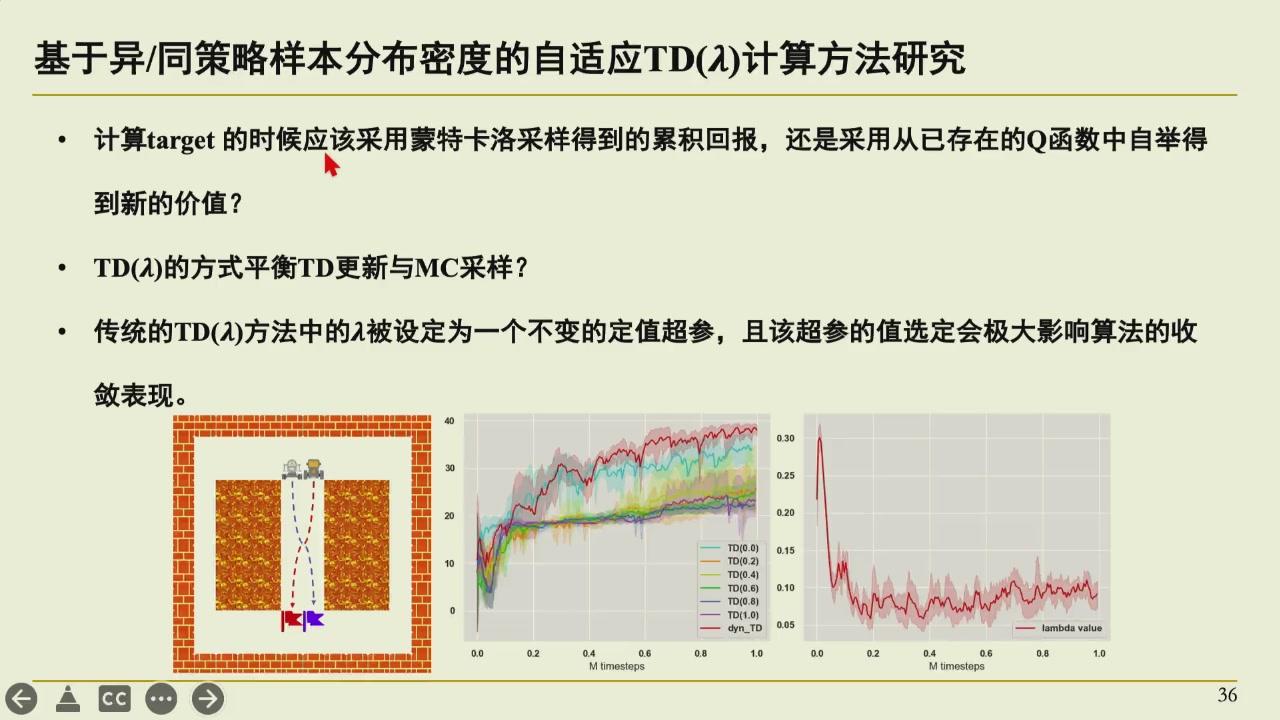
该图讨论一种自适应多步目标设计。它提示读者区分目标的偏差和方差权衡,以及样本的行为策略分布。
思考题
蒙特卡洛和一步 TD 的学习目标有什么差别?
答案
蒙特卡洛等完整轨迹结束,用实际回报 \(G_t\) 作为目标,偏差小但方差大。一步 TD 用 \(r_{t+1}+\gamma V(s_{t+1})\),可以在线更新,但目标依赖当前估计,会引入自举偏差。TD(\(\lambda\)) 在两者之间折中。
思考题
TD(\(\lambda\)) 里的 \(\lambda\) 从 0 变到 1,学习目标会怎样移动?
答案
\(\lambda=0\) 接近一步 TD,依赖下一状态的当前估计,偏差较高但方差较低。\(\lambda=1\) 接近完整蒙特卡洛回报,依赖整条轨迹的真实奖励,偏差较低但方差较高。中间值按多步目标加权,在两者之间折中。
Bellman 目标与终止状态
价值学习的样本来自连续交互。一步 TD 的目标为
\(y_t\) 是 TD 目标,\(r_t\) 是当前 transition 的奖励,\(d_t\) 是终止标记,\(\bar\theta\) 表示目标网络的较旧参数副本。终止时 \(d_t=1\),后半项变为 0。
其中 d_t 表示真正终止,终止后不应再 bootstrap。很多环境还会因时间上限截断 episode。截断是否等价于终止取决于任务定义。收集器强制停止而理论 MDP 仍有后继状态时,把它当终止会引入价值偏差。经验回放至少应保存 observation、action、reward、next observation、terminated/truncated 与必要的 mask,保留边界语义。
目标网络(target network)\(\bar\theta\) 在一段时间内保存较旧参数,使 bootstrap 目标保持相对稳定。每一步都用正在更新的 \(\theta\) 同时定义预测和目标时,误差会追逐自身变化,容易发散。定期硬更新或指数滑动平均更新 target 都用于控制这种反馈。Double DQN(Double Deep Q-Network,双重深度 Q 网络)将动作选择交给 online 网络,将动作评估交给目标网络,缓解 max 对噪声的系统性高估。1 2
On-policy 与 Off-policy
行为策略 \(\mu\) 负责采集轨迹,目标策略 \(\pi\) 是希望学习或评估的策略。两者相同时,方法称为 on-policy。两者不同时,方法称为 off-policy。on-policy 方法通常要求数据接近当前策略,例如一轮更新后再用新策略采样。它概念直接,旧数据却很快无法反复使用。
off-policy 方法允许利用历史经验回放缓存(replay buffer)中的数据。DQN(Deep Q-Network,深度 Q 网络)一类方法将过去轨迹存入缓存,随机抽取 mini-batch,降低相邻样本的相关性并提高样本复用率。旧数据由较早的策略产生,和当前策略之间可能存在分布差异。重要性采样可用概率比修正这种差异,权重很大时也会带来高方差。1
一个具体例子能说明行为策略与目标策略的差别。行为策略采用 \(\epsilon\)-greedy(以小概率随机探索、其余时间选择当前最优动作),在状态 \(s\) 以 0.1 概率随机均匀选择四个动作,以 0.9 概率选择当前认为最好的右。目标策略可以是纯贪心,只在 \(s\) 选择右。训练 DQN 时,buffer 中会有大量左、上、下的样本。这些样本仍能帮助估计各个动作的 \(Q\),但不能代表目标策略将来访问 \(s\) 的频率。重要性采样按
分子 \(\pi(a\mid s)\) 是目标策略选择已采样动作 \(a\) 的概率,分母 \(\mu(a\mid s)\) 是行为策略实际采到这个动作的概率。两者的比值把旧策略样本重新加权到目标策略附近。
给旧样本加权。目标策略几乎不选某个动作、行为策略经常选它时,权重会变得很小。相反的情况会产生很大的权重。
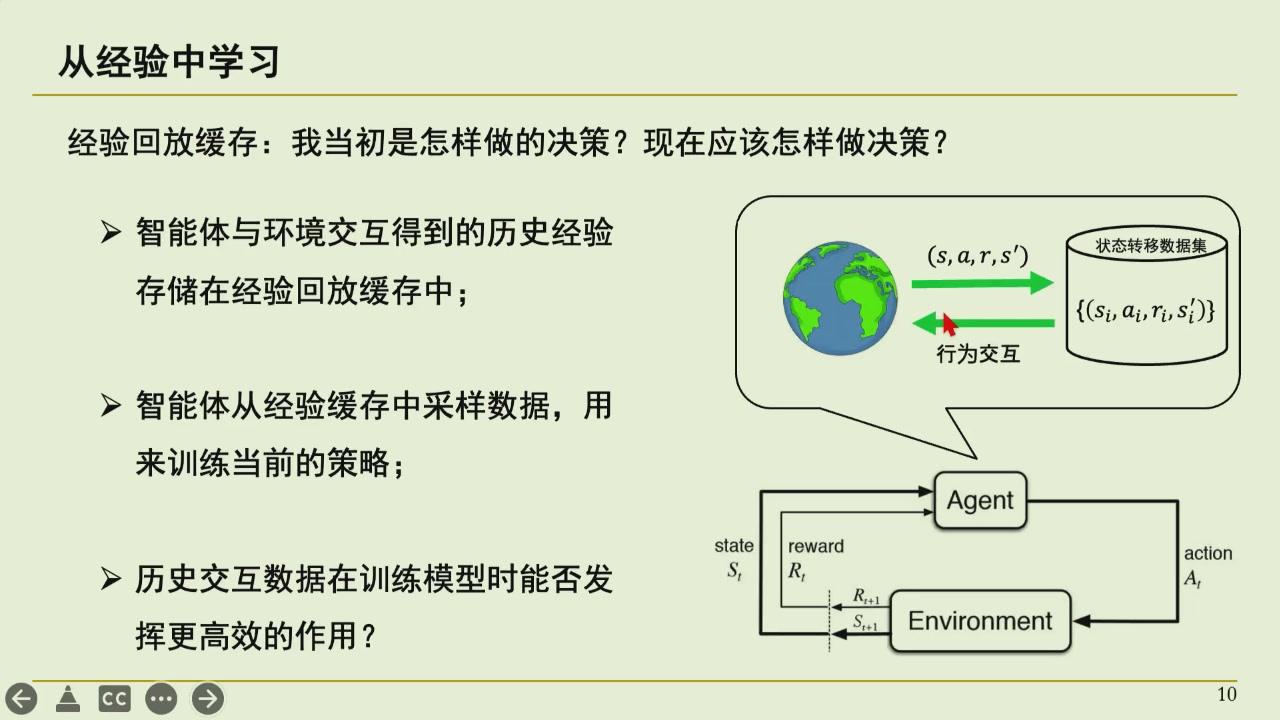
经验回放缓存保存大量过去轨迹,供训练反复采样。它提高样本复用率,也带来旧数据与当前策略分布不一致的问题。
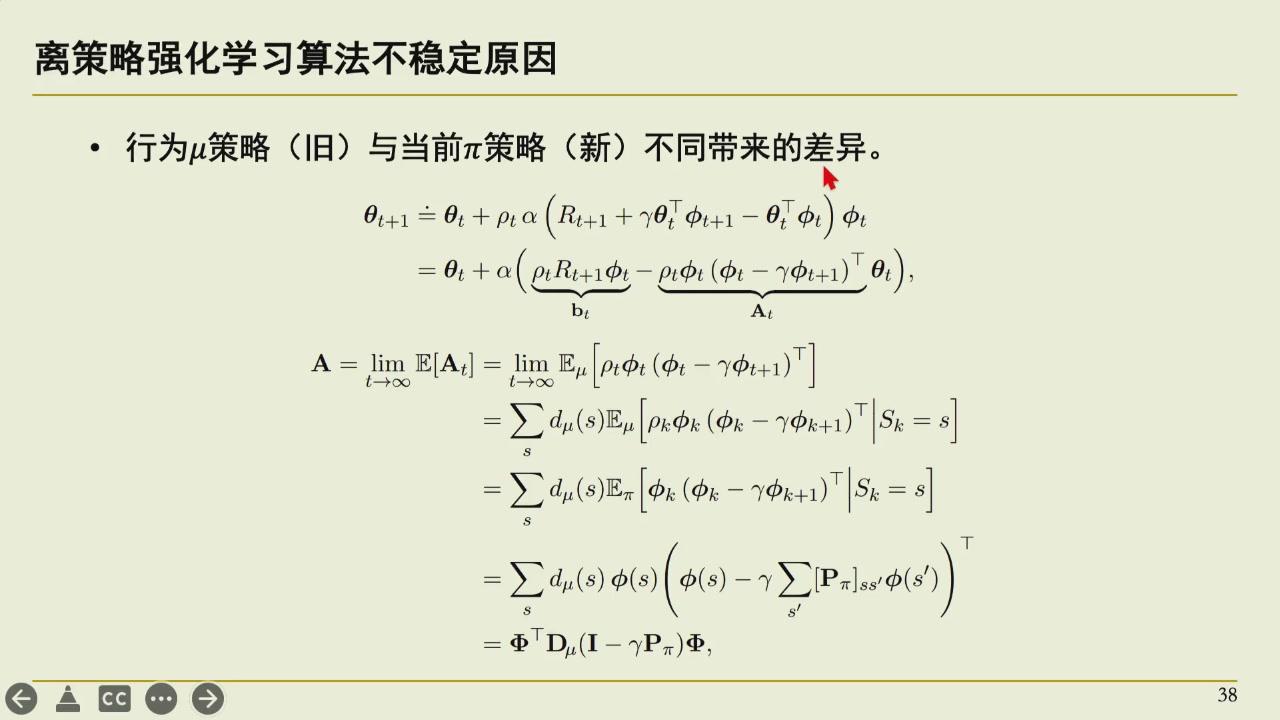
旧策略采样的数据分布与当前策略不同,这是 off-policy 训练不稳定的来源。重要性采样是修正手段之一。
一种可验证的设计是把当前策略采集的数据与历史 off-policy 数据分开管理,再按数据新鲜度、行为策略差异和训练阶段选择多步目标或采样权重。当前策略附近的数据更贴近现有决策分布。历史数据可能保存罕见的成功轨迹。两类数据应在日志中分别统计采样比例、TD 误差和成功率。
思考题
监督学习和强化学习的训练信号有什么本质差别?为什么这个差别会带来探索问题?
答案
监督学习每个输入旁边有正确标签,错误可以立刻从预测和标签比较出来。强化学习通常只看到动作后的奖励,同一状态的不同动作可能都要试过才知道好坏,而且奖励可能延迟出现。若策略总是选已知动作,就无法发现更优动作,因此需要探索。
思考题
为什么 on-policy 方法不能随意复用旧数据,而 off-policy 方法常常能使用 replay buffer?
答案
on-policy 的估计和更新假设数据来自当前目标策略,或与它足够接近。策略更新后,旧轨迹的分布不再代表新策略,继续使用会引入偏差。off-policy 明确区分采样策略和目标策略,通过重要性采样或 Q-learning 类目标修正,因此可以复用更多历史数据。
思考题
重要性采样权重 \(\pi(a|s)/\mu(a|s)\) 很大时,会带来什么问题?
答案
说明目标策略很愿意选择某个动作,而采样策略很少选它。少数旧样本会被赋予很大权重,估计方差急剧上升,训练不稳定。需要裁剪、限制重采样范围或重新采样更接近目标策略的数据。
数据复用、探索与多智能体
多智能体强化学习
多智能体强化学习(multi-agent reinforcement learning,MARL)中,多个 agent 同时观察、行动和学习。每个 agent 的动作都会改变其他 agent 看到的环境,所以单个 agent 所面对的环境会随其他策略更新而变化,非平稳性比单智能体更明显。
考虑两个机器人共同搬桌子。机器人 A 学会向左转,机器人 B 若仍按旧策略向前推,桌子会碰撞;B 改成配合左转后,A 原来的最优动作又可能失效。对 A 来说,环境动力学不仅由物理规律决定,也由 B 的策略决定。训练过程中 B 不断更新,A 看到的转移分布随之变化。MARL 的困难主要来自这个非平稳目标,而不是简单地把单智能体算法并行运行多份。
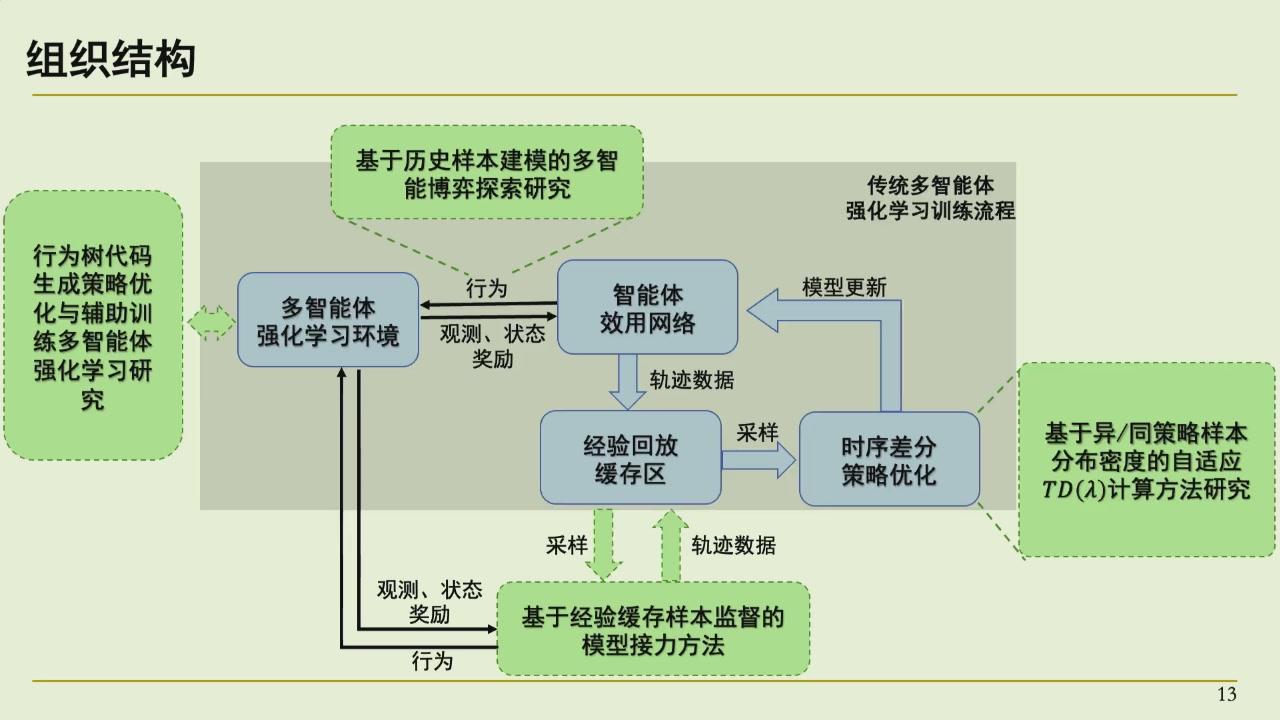
多个智能体从环境收集观测和奖励,再用轨迹更新策略。
合作任务常采用 CTDE(centralized training, decentralized execution,集中训练、分散执行)。训练时可使用全局状态、所有 agent 的动作或联合价值函数。执行时,每个 agent 只用自己允许获得的局部观测独立行动。这样训练阶段能减少价值估计歧义,部署时也不要求实时汇集所有信息。5
QMIX 是一个合作型多智能体值分解方法。每个 agent 先有局部 \(Q_i\),再由 mixing network(混合网络)合成为全局 \(Q_{tot}\),并约束全局值对各局部值单调。于是选择各 agent 局部最优动作时,与联合 \(Q_{tot}\) 的贪心选择能够保持一致。它适合合作且可做这种单调分解的任务,不意味着任何多智能体博弈都能被简单拆成若干独立 Q 函数。 6
CTDE 的实现还要处理参数共享和训练吞吐。共享参数能提高样本效率,却要求智能体的观测/动作空间兼容,并常需 agent id 或位置编码防止完全对称的策略塌缩。Isaac Gym 等工具可在 GPU 上并行许多环境,但每一步仍包含物理计算、policy inference、状态重置、reward 计算和把 batch 交给学习器。profile 时应分别量环境 step、rollout 传输、前后向和优化器;只把环境数量翻倍,可能先撞到显存、物理 kernel 或 policy batch 的瓶颈。
探索与经验复用
稀疏奖励环境中,智能体可能在很长时间内看不到成功反馈。若直线方向被墙挡住,反复从起点沿同一方向探索只会撞墙。绕开的成功路径则值得被反复利用。探索应保留罕见且有信息量的经验。
\(\epsilon\)-greedy 可以用期望值解释。设当前贪心动作估计价值为 8,其余三个动作估计价值分别为 5、4、3。若 \(\epsilon=0.1\),在四个动作均匀随机的情况下,一步的期望贪心部分约为
探索牺牲了少量当前期望回报,换来对其他动作真实价值的持续检查。\(\epsilon\) 太大时策略接近乱走,太小又可能长期错过更好的动作,因此常随训练逐步衰减。
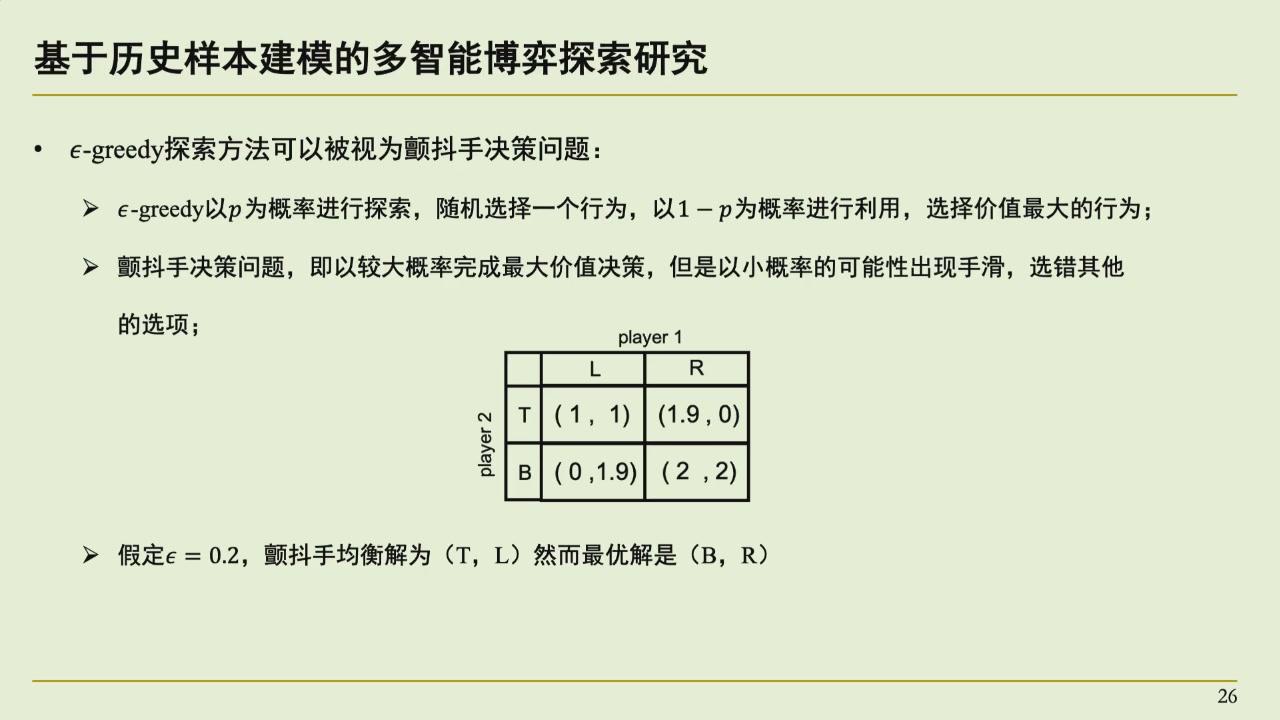
ε-greedy 用一个小概率随机探索,其余时间按当前最优行动。探索噪声过大或过小都会影响学习结果。
这一思路把历史上表现好的轨迹变成模板。当前状态与模板匹配时,训练目标可以加入模板对应的价值或动作倾向。偏离模板的部分仍由普通 RL 学习。环境变化后,是否采用模板要通过状态匹配、置信度或价值比较来决定。
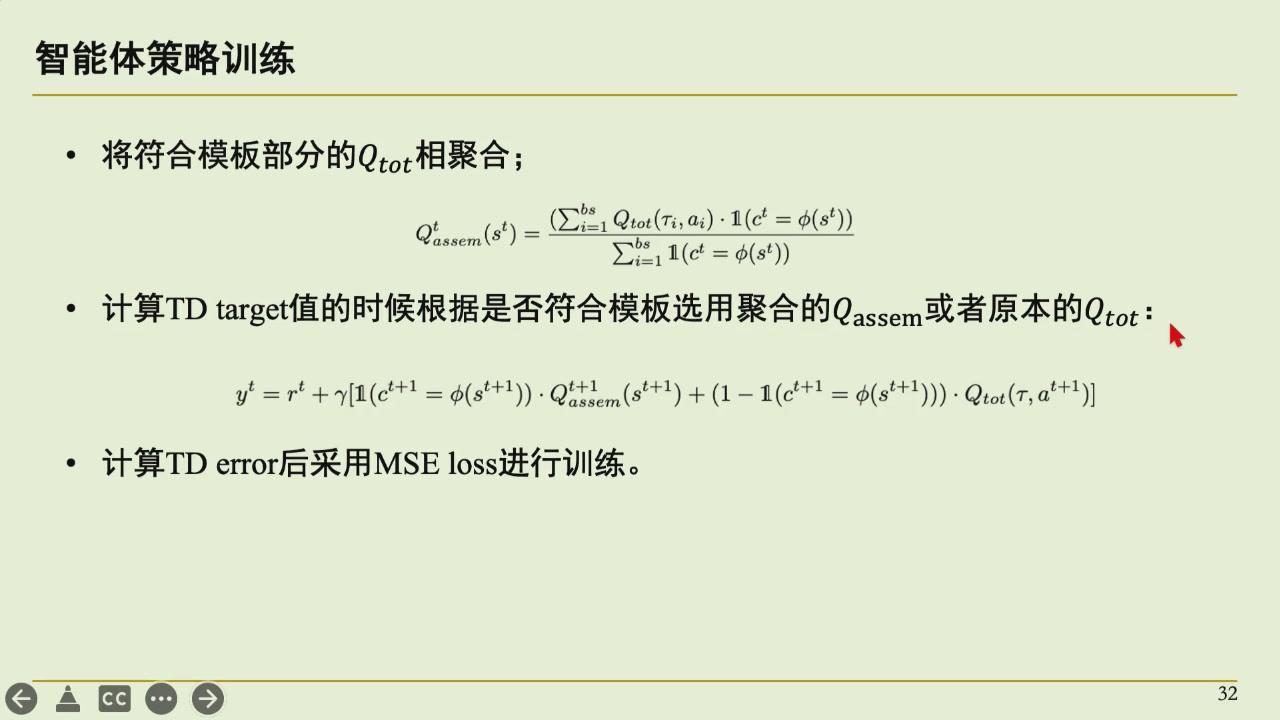
模板保存罕见的成功经验,用于指导当前状态的行动倾向。是否采用模板由状态匹配或价值比较决定。
蒙特卡洛树搜索(Monte Carlo tree search,MCTS)通过在当前状态附近展开搜索来比较后续动作。它反复执行选择、扩展、评估和回传。从根节点按选择公式走到叶子,扩展可行动作,使用 rollout 或价值网络评估叶子,再把回报更新到祖先节点。选择公式会兼顾平均价值与访问次数较少的分支,因此同时利用和探索。它在围棋等可模拟环境中很强,每一步展开搜索也会产生较高代价。
思考题
\(\epsilon\)-greedy 探索有什么优缺点?为什么复杂任务还需要更系统的探索方法?
答案
\(\epsilon\)-greedy 以概率 $ arepsilon$ 随机选动作,其余时间选当前最优动作,实现简单。但随机探索不区分哪些动作更有信息量,稀疏奖励下可能长期碰不到成功轨迹。参数噪声、计数 bonus、内在奖励和树搜索等方法会更有目的性地尝试未知区域。
策略表示、规划与优化
神经策略与行为树
深度 RL 策略可以直接把观测映射为动作,却往往难解释、迁移不稳定,需要大量交互数据。一种方向是用大模型生成的行为树或决策树作为元策略。
行为树将任务写成条件、动作以及顺序/选择/并行等控制节点。例如若手边有物体则抓取、否则先移动到目标附近这样的表述,比一个连续网络输出更容易检查和修改。大模型可以根据任务描述、环境接口和失败记录生成或修改树;RL 则可用于调树中的参数、优先级或局部动作。行为树负责可检查的高层流程,连续控制仍交给合适的低层策略。语言模型可参与生成或修改树,但不直接取代底层控制器。
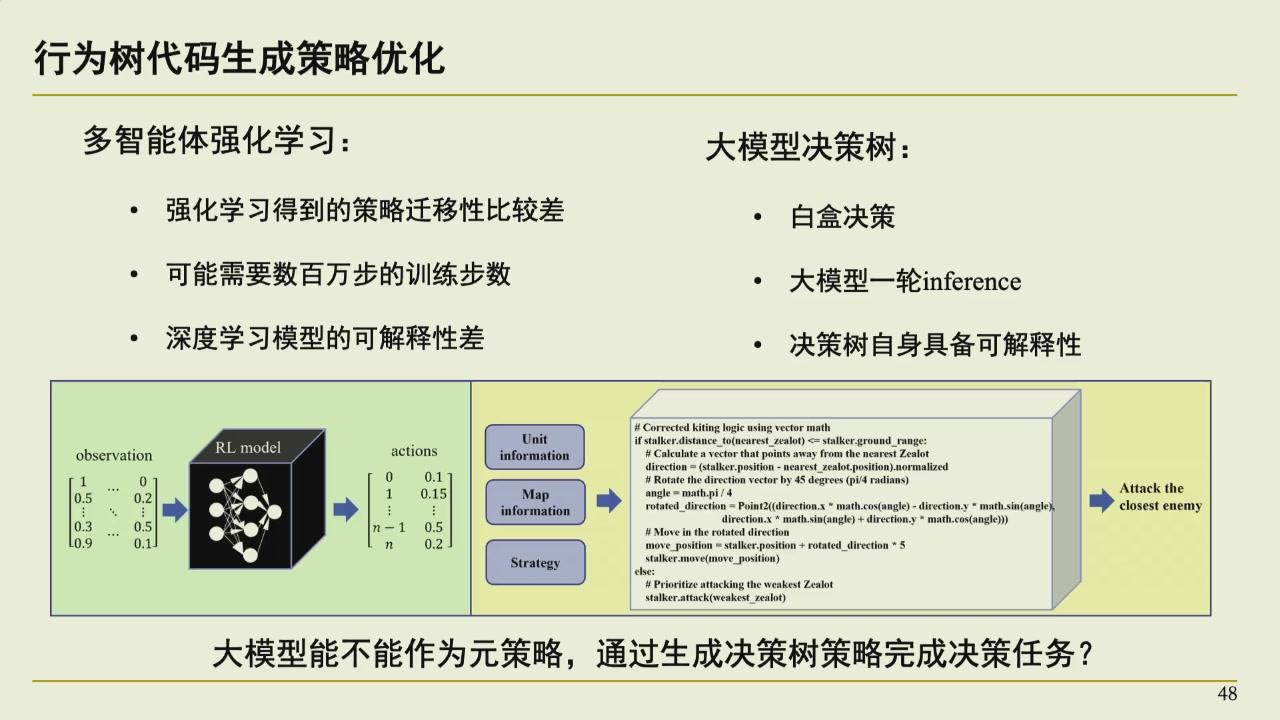
行为树由顺序、选择、并行等控制节点组织条件与动作。大模型可以生成或修改树,低层连续控制仍由策略完成。
思考题
为什么很多机器人系统不把所有决策都交给端到端神经网络?
答案
安全边界、急停、限位和任务状态机需要可验证的确定性规则。神经网络擅长感知和控制等复杂映射,但失败模式难以穷举。工程系统常用行为树或状态机管理边界,再调用学习到的策略完成局部决策。
思考题
行为树中的高层控制由人写规则,低层动作由神经网络输出。这种混合结构比纯端到端策略多了什么保障,又少了什么灵活性?
答案
行为树把顺序、条件、失败回退等控制流显式写出来,容易检查、修改和设置安全边界。低层策略仍能处理连续控制和感知变化。代价是高层流程不如端到端学习灵活,环境任务改变时需要维护树结构或重新设计分支。
基于模型的方法
无模型强化学习直接学习策略或价值,不显式学习环境如何变化。基于模型的强化学习(model-based RL)还学习或使用一个动力学模型。给定状态和动作后,模型预测下一状态、奖励或观测。这样可以在模型里滚动多步,比较候选动作,减少真实环境中的试错。
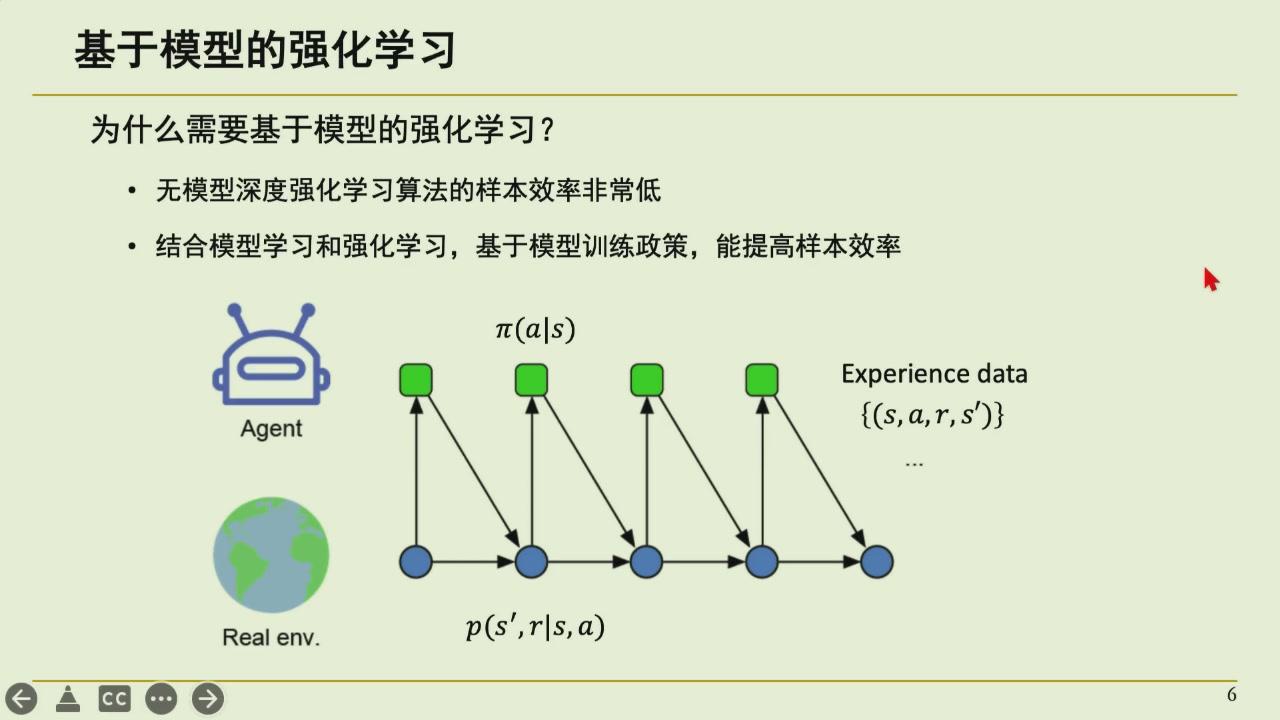
在低成本的世界模型里多滚动几步做规划,可以减少真实环境中的交互样本。
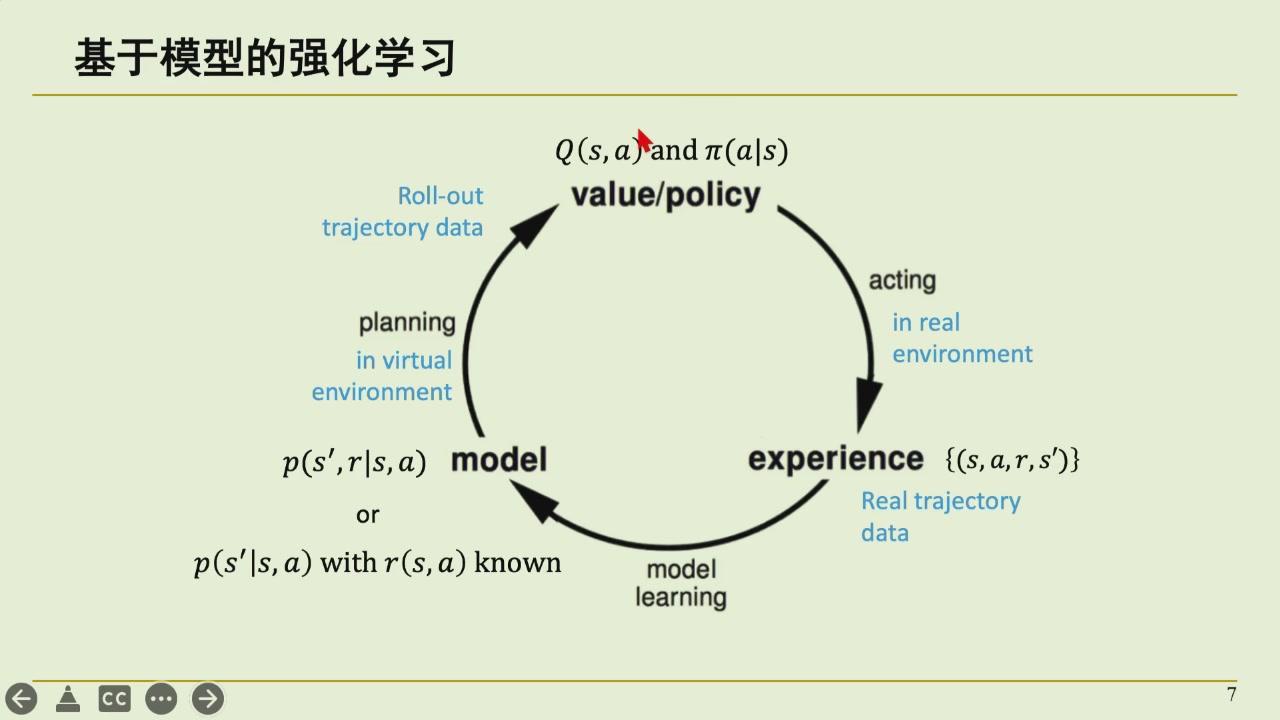
model-based RL 在学习策略之外增加模型规划,以提高样本效率和探索质量。
模型不准时会出现 model bias(模型偏差),即规划过程可能系统性利用模型与真实环境之间的差异。真实执行因此可能失败。可以用不确定性估计、短视规划、真实数据校正或模型集成减轻这种影响。相关研究关注如何从历史样本构造可用模型,并和策略学习结合,以提高样本效率和探索质量。
历史经验样本可以降低多智能体训练的早期困难。多智能体强化学习起步阶段 Q 值尚未收敛,每一步的自举误差较大,并会沿决策树向根节点回传。一个研究思路是把经验缓存里的历史轨迹整理成轨迹树,先用有监督的行为克隆学习基本动作,再用多智能体强化学习继续细化。
思考题
基于模型的强化学习为什么可能样本效率更高,但也会学得更不可靠?
答案
它训练环境模型来生成额外 rollout,减少真实交互次数。若模型预测误差被策略利用,规划出的动作在真实环境中可能失败。通常需要区分模型 rollout 和真实数据,并限制模型的使用范围。
思考题
学习的环境模型有误差时,为什么 planner 反而可能做出很差的动作?
答案
规划会主动寻找模型认为回报高的动作序列。若模型在某些区域系统性高估回报或低估风险,这些错误会被规划放大,智能体可能选择现实中不可行的路径。基于模型的方法需要处理模型不确定度,限制规划范围,并用真实交互校准。
策略梯度的采样路径
随机策略 \(\pi_\theta(a\mid s)\) 的目标梯度可写为
\(J(\theta)\) 是策略的期望回报,\(\theta\) 是策略网络参数,\(\nabla_\theta\log\pi_\theta(a_t\mid s_t)\) 表示提高已采样动作对数概率的方向,\(A_t\) 决定这次样本应加强还是减弱该方向。
优势 \(A_t\) 表示动作相对状态基线的收益;减去只依赖状态的 baseline(基线)不改变期望梯度,却能显著减小方差。actor-critic 结构中,actor 是输出动作概率的策略网络,critic 是估计状态价值的网络;critic 的 value 可作为 baseline。GAE(generalized advantage estimation)用带参数 \(\lambda\) 的多步 TD 残差在偏差与方差间折中。这里的 rollout 是训练数据生成过程,动作、log probability、value、reward 和 done 必须来自同一个策略版本;把不同版本轨迹混入 on-policy 更新会破坏目标分布。
策略梯度公式可以用两个动作的 softmax 看清楚。设状态 \(s\) 有两个动作,策略网络输出 logits \(z=[1,2]\),则
若采样到“右”且优势 \(A=+1\),softmax 的对数概率梯度为
梯度上升会提高“右”的 logit、降低“左”的 logit。若同一个动作的 \(A=-1\),更新方向相反。优势相当于给这次采样打分,策略梯度决定这个分数如何回传到动作概率上。
策略梯度自测
状态 \(s\) 有两个动作,logits 为 \([0,1]\)。采样到第二个动作,优势为 \(-1\)。判断更新方向。
先算概率,\(\pi=[0.269,0.731]\)。对数概率梯度为 \(\mathrm{onehot}(a_2)-\pi=[-0.269,0.269]\),乘以 \(A=-1\) 后得到 \([0.269,-0.269]\)。梯度上升会降低第二个动作的 logit、提高第一个动作的 logit。
思考题
为什么策略梯度通常要减去 baseline?baseline 改变了期望梯度吗?
答案
原始梯度方差很大,很多采样到的回报可能只反映状态本身好坏。baseline 例如 \(V(s)\) 提供一个比较基准,只保留动作相对优势。只要 baseline 不依赖动作,理论上不改变期望梯度,却能降低方差,让训练更稳定。
PPO(近端策略优化)的更新
PPO(proximal policy optimization)在采样策略 \(\pi_{old}\) 产生的 rollout 上多轮更新新策略,并使用新旧策略的概率比值。4
\(r_t(\theta)\) 是当前策略与采样策略在同一状态、同一动作上的概率比值。\(\pi_{old}\) 是收集 rollout 时冻结保存的旧策略,\(\pi_\theta\) 是正在更新的新策略。
并把目标中的 \(r_t A_t\) 裁剪到 \([1-\epsilon,1+\epsilon]\) 附近。裁剪并不保证严格的信赖域,却阻止一次 mini-batch 更新把已采样动作的概率推得过远。实现中必须保存采样时的 old log-prob;重新用当前网络计算后再当作 old 值,会使比值恒为 1,训练表面运行而没有正确约束。
取 \(\epsilon=0.2\),可接受区间为 \([0.8,1.2]\)。若优势 \(A=+1\),新策略把该动作概率提高到旧策略的 1.5 倍,\(rA=1.5\);裁剪后的目标按 1.2 计,继续提高概率不再增加目标。若优势 \(A=-1\),而新策略把概率降到旧策略的 0.5 倍,\(rA=-0.5\);裁剪项为 \(0.8\times(-1)=-0.8\),PPO 的最小值目标会限制这种过度下降。裁剪的意义在于控制每次更新偏离采样分布的幅度,让同一批 rollout 可以安全地多轮更新。
PPO 数值检验
设 \(\epsilon=0.2\)、优势 \(A=+2\)、概率比值 \(r=1.1\)。未裁剪目标是多少?若 \(r\) 增大到 1.5,裁剪后目标是多少?
\(r=1.1\) 位于 \([0.8,1.2]\) 内,目标为 \(rA=2.2\)。\(r=1.5\) 时裁剪为 1.2,目标为 \(1.2\times2=2.4\)。优势为正时,概率继续提高超过 1.2 倍后,目标不再随之增加。
rollout buffer 还要保留连续的时间维度,因为 GAE 要从 episode 末尾向前递推 TD 残差。拼接多个环境时,done mask 要在各环境各自的终点截断递推;把一个环境终点的 value 泄漏到另一个环境开头,是批处理维度处理错误,不是算法随机性。优势常在一个 batch 内标准化以改善优化尺度,但 reward 的物理含义和终止奖励仍应在标准化前检查。 3
思考题
PPO 的 clip 目标为什么能限制单次更新幅度?ratio 离 1 很远时会发生什么?
答案
ratio 表示新策略与采样策略的概率比值。若优势为正,更新希望增大该动作概率,clip 会把过大的 ratio 截在上界;优势为负时则截在下界。这样单次更新不会让策略离采样分布太远。ratio 异常大或小也提示数据分布和目标策略差距过大,应减小步长或重新采样。
奖励、观测与部署偏移
强化学习优化的是实现给出的 reward,不是人心中未写出的任务。奖励中某项权重大、某个失败状态遗漏惩罚、终止条件可以被钻空子,策略就可能学到看似怪异却能提高回报的行为。调试应同时记录分项 reward、成功率、episode 长度、动作幅度和关键状态,而不是只看总回报曲线。总回报上升而真实任务失败,通常需要回到环境语义和观测/动作变换检查。
奖励漏洞的一个常见形式是代理指标替代真实目标。若清洁机器人的奖励是传感器看到的灰尘减少量,它可能学会把灰尘扫到传感器看不到的角落;若机器人抓取任务的奖励只按末端高度计算,它可能把杯子举高而不稳定抓握。奖励上升只说明优化器找到了实现定义的最大值,不能自动说明任务完成。调试时应记录分项奖励、真实成功率、动作幅度和终止原因,再检查奖励函数是否遗漏了失败状态。
练习:找奖励漏洞
搬箱任务的奖励实现为 reward = 10 * height(box) - 0.01 * action_norm。测试中发现机器人把箱子举到最高处并保持不动,总回报很高,但没有把它送到目标点。
详细答案
height(box) 只是代理指标。它奖励把箱子举高,却没有要求箱子靠近目标、保持稳定、避免碰撞或最终放下。因此策略停在高处也能得到持续回报。
奖励可以加入目标距离、姿态稳定、碰撞惩罚和成功终止条件。例如在箱子接近目标且速度足够小、姿态满足条件时给一次较大的成功奖励;在掉落、碰撞或超时后终止并记录失败原因。日志应分别保存真实成功率、各项奖励、动作幅度和 episode 终止原因。
仿真到真实设备还存在观测延迟、摩擦、传感器噪声和执行器饱和等偏移。domain randomization 指在训练时随机这些参数,让策略学习对变化更稳健的控制规律。随机范围脱离真实设备时,训练任务会变得不必要地困难。部署前需要在受限动作、急停和日志条件下逐步验证。
思考题
domain randomization 能减小仿真到真实差异,为什么随机范围越大并不一定越好?
答案
范围过窄会让策略只适合理想参数,迁移时容易失败。范围过大又会把大量无关或不可能的环境交给策略学习,任务难度上升,甚至学出过度保守的动作。随机项和范围应参考真实设备的观测、摩擦、延迟和执行器约束来设定。
思考题
总回报上升但真实任务成功率下降,应该先检查什么?
答案
先检查奖励函数是否被钻空子,分项 reward、终止条件和观测是否遗漏了关键约束。再核对成功率、动作幅度、episode 长度和终止原因。总回报只是优化目标,不自动等价于任务完成。
具身智能
具身智能(embodied AI)关心的是让智能体通过身体与环境交互来完成任务。机器人是强化学习很自然的应用,但真实机器人采样慢、硬件会磨损、失败可能危险。
训练通常先在模拟器中进行大规模并行交互,再把策略迁移到真实设备。模拟器可随机质量、摩擦、光照、传感器噪声和初始位置,减小策略对某一组理想参数的依赖。这种训练设置称为 domain randomization(领域随机化)。7
Isaac Gym 是 NVIDIA 提供的 GPU 物理仿真环境。它将物理仿真放到 GPU 上,一次可并行推进许多环境。只有一个环境时,数百万步交互可能耗时很久。成千上万个并行环境可显著提高采样吞吐。并行环境的初始状态、随机种子和数据同步仍要认真处理,否则会得到高度相似的大量轨迹。8
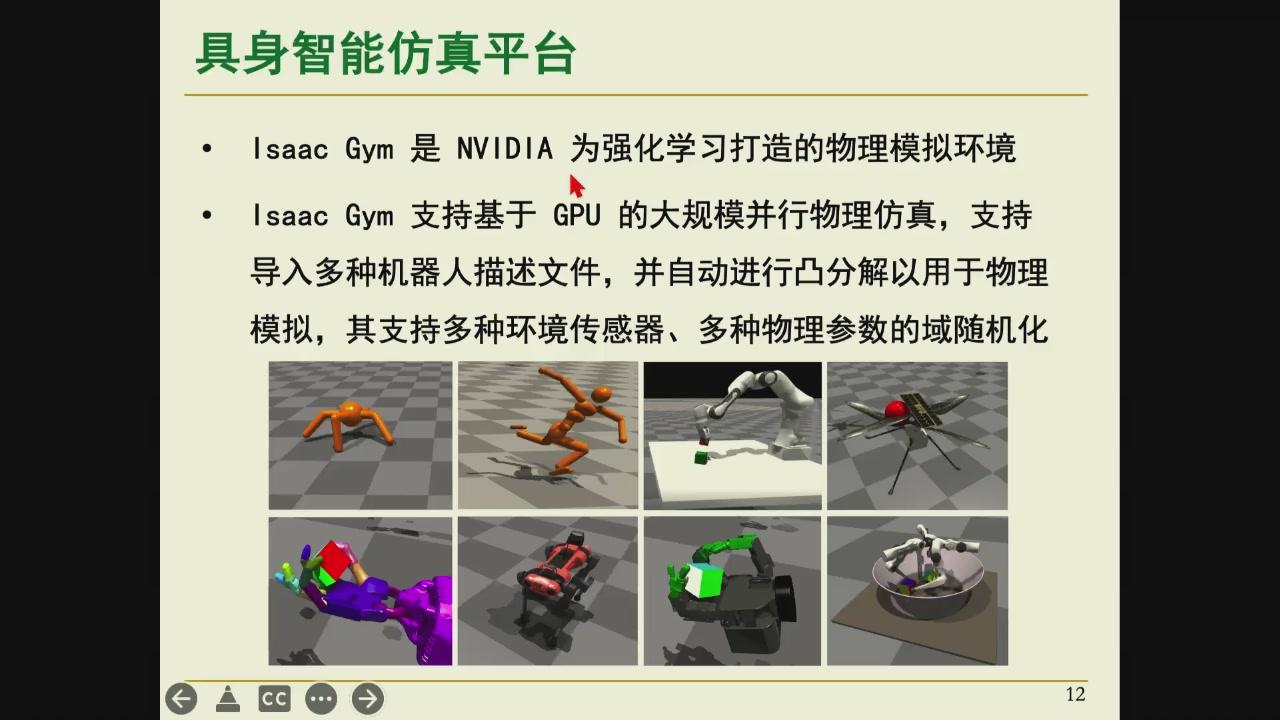
物理仿真放入 GPU 后,多个环境可并行交互。吞吐提升依赖正确处理环境初始状态、随机种子和数据同步。
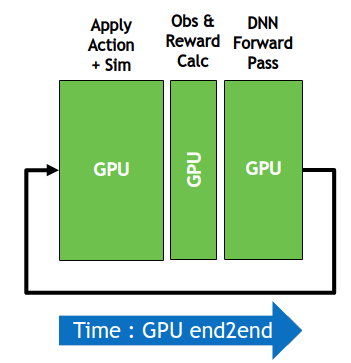
这张图对应交互链 观测 → 动作 → transition → 更新。绿色方块表示同一端到端流程中的 GPU 工作阶段,包括物理仿真、观测与奖励计算、策略网络前向。将这些阶段留在设备侧,可以减少 CPU 往返和小步同步;训练算法仍要在交互数据上计算回报、优势和梯度。8
模仿学习从人类演示或遥操作轨迹出发,先学一个能完成基本动作的策略,再用强化学习(reinforcement learning,RL)微调。Mobile ALOHA 一类双臂移动操作平台展示端到端任务,例如移动、抓取、整理。这类任务还要处理长时序误差累积、视觉遮挡、接触不确定性和任务切换。9
行为克隆是模仿学习的基本形式。数据包含 \((\text{观测},\text{专家动作})\),训练目标与监督学习相同,即最小化专家动作与模型输出的交叉熵。它会遇到分布偏移。专家轨迹大多停留在正确状态附近。模型一旦犯一个小错,进入专家数据中少见的状态,后续错误可能继续放大。实用系统常用数据增广、扰动恢复数据、失败案例和在线纠正来覆盖这些状态,再让强化学习根据环境反馈继续改进。DAgger(Dataset Aggregation,数据集聚合)一类交互式模仿学习方法通过在学习策略访问到的状态上继续获取专家标注来缓解分布偏移。10
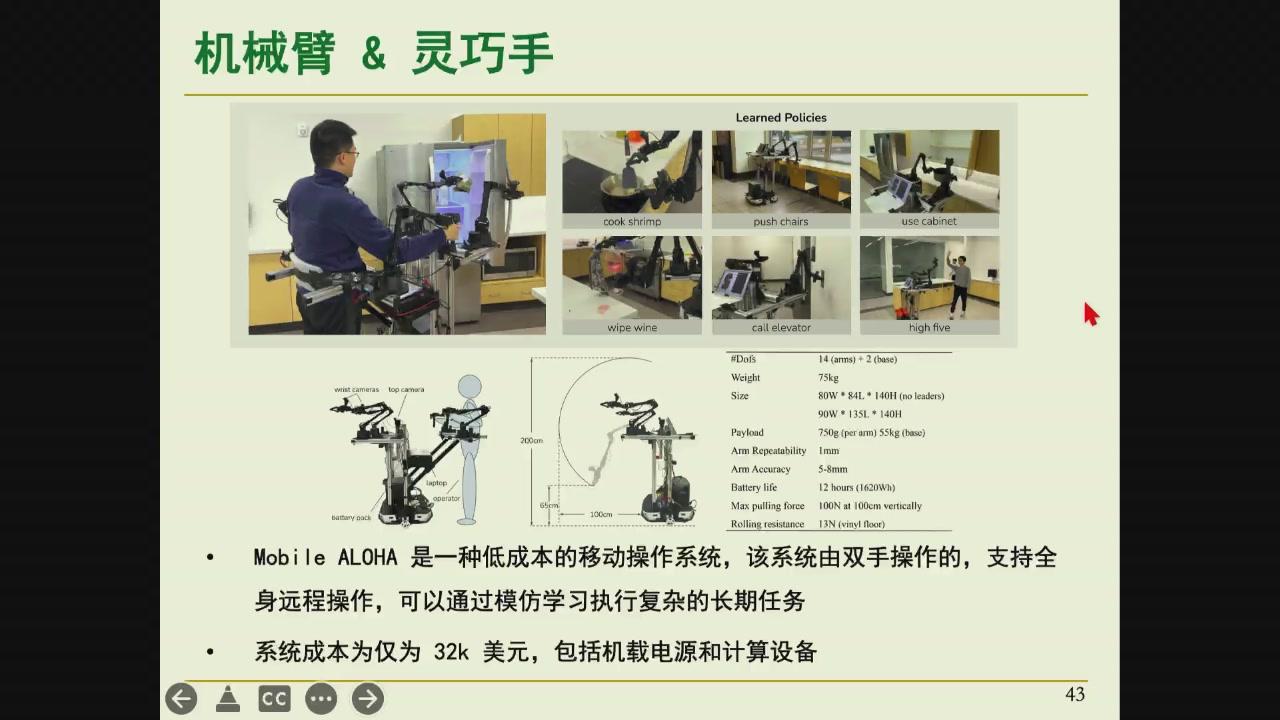
端到端机器人任务需要处理长时序误差、视觉遮挡和接触不确定性。
具身系统的部署验收至少覆盖下面几项。
- 动作幅度和变化速度是否在执行器允许范围内。
- 感知延迟与控制频率变化时,策略是否仍然稳定。
- 物体位置、摩擦或光照偏离训练分布后,失败能否被检测并恢复。
- 急停、限位和日志是否独立于学习策略工作。
强化学习覆盖从交互数据改进决策的一部分工作。数据采集、仿真吞吐、控制回路和系统可靠性同样决定机器人是否可用。
思考题
行为克隆为什么会在小错误后越错越远?
答案
训练数据多来自专家轨迹,专家很少进入偏离后的状态。模型一旦犯小错,后续观测落在训练分布之外,策略没有学过如何恢复,误差可能继续累积。需要加入扰动恢复数据、失败案例或在线强化学习。
-
V. Mnih et al., Playing Atari with Deep Reinforcement Learning, https://arxiv.org/abs/1312.5602. ↩↩
-
H. van Hasselt, A. Guez, D. Silver, Deep Reinforcement Learning with Double Q-learning, https://arxiv.org/abs/1509.06461. ↩
-
J. Schulman et al., High-Dimensional Continuous Control Using Generalized Advantage Estimation, https://arxiv.org/abs/1506.02438. ↩↩
-
J. Schulman et al., Proximal Policy Optimization Algorithms, https://arxiv.org/abs/1707.06347. ↩
-
R. Lowe et al., Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments, https://arxiv.org/abs/1706.02275. ↩
-
T. Rashid et al., QMIX: Monotonic Value Function Factorisation for Deep Multi-Agent Reinforcement Learning, https://arxiv.org/abs/1803.11485. ↩
-
J. Tobin et al., Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World, https://arxiv.org/abs/1703.06907. ↩
-
V. Makoviychuk et al., Isaac Gym: High Performance GPU-Based Physics Simulation for Robot Learning, https://arxiv.org/abs/2108.10470. ↩↩
-
T. Fu et al., Mobile ALOHA: Learning Bimanual Mobile Manipulation with Low-Cost Whole-Body Teleoperation, https://arxiv.org/abs/2401.02117. ↩
-
S. Ross, G. Gordon, D. Bagnell, A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning, https://arxiv.org/abs/1011.0686. ↩
-
R. Sutton and A. Barto, Reinforcement Learning: An Introduction , 2nd ed., http://incompleteideas.net/book/the-book-2nd.html. ↩↩↩
-
Farama Foundation, Gymnasium Documentation, https://gymnasium.farama.org/. ↩↩
 本站总浏览