07-10 下午:向量化并行计算基础
这一节讨论一段连续数组上的循环。它很小,却经常位于大程序最里面。Lab 2 中的路由、缩放和矩阵乘法,最终都会把一批数读入寄存器,完成运算,再写回数组。
SIMD(single instruction, multiple data,单指令多数据)让一条机器指令同时处理一小组同类型元素。向量寄存器里的每个位置称为 lane。归约则把多份局部结果合并为一个数,例如求和或取最大值。SIMD 适合批量执行同一种操作,归约适合将多份局部结果合成一个结果。12
NumPy 用户指南关于广播的说明(译)
广播让形状不同但兼容的数组参与同一次运算。它提供一种在 C 中通常需要显式循环才能写出的数组表达方式。实现是否复制数据取决于具体操作和数组布局。3
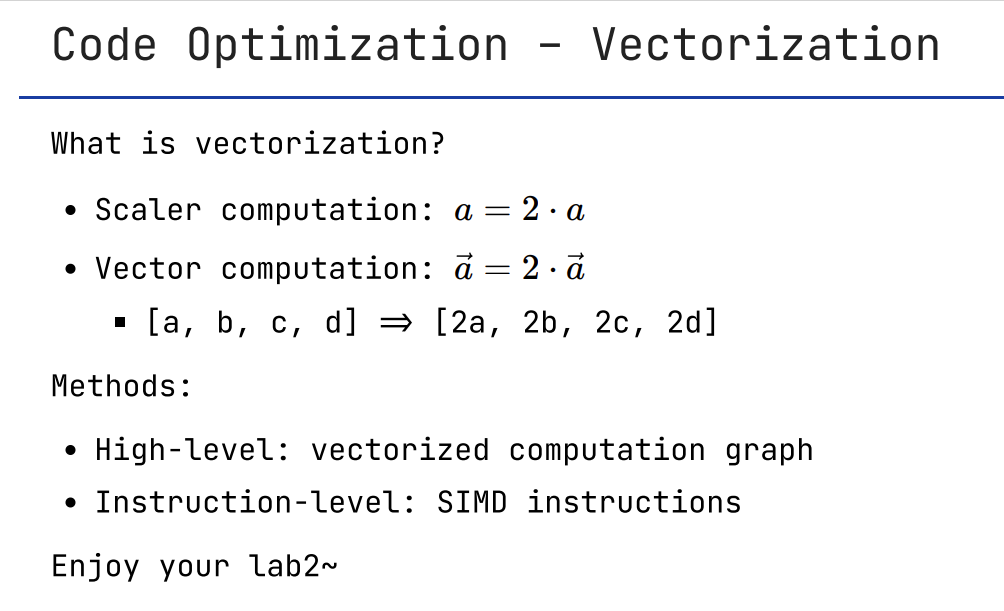
高层数组表达与指令级 SIMD 可以共同出现。数组库会尝试调用向量化的底层 kernel。循环存在真实依赖时,需要先改变算法或保留顺序执行。2
从数组表达式到 SIMD 指令
先写清数组在计算什么,再观察它能否变成向量指令。下面四项适合在阅读一个 kernel(内核函数)时逐一核对;其中任意一项不成立,优化方向都会改变。
先确定输入、输出和 shape(各维长度)。例如 y = a*x + b 中,哪个维度是 token,哪个是 hidden,数组如何广播,结果是否原地写回,都应能从代码旁的说明看出来。
只有不同迭代互不依赖,编译器和线程才可以改变执行顺序。前缀和、直方图和共享累加器都要读到其他迭代写出的数据,需要归约、分桶或专门算法。
向量加载、缓存行和硬件预取都更容易处理连续地址。矩阵或张量的最内层循环应沿连续维度访问;之后才考虑分块、packing(重排成库需要的布局)或布局转换。
编译器报告可说明循环有没有生成向量指令,计时和 profiler(性能分析器)则说明它是否值得继续优化。Lab 2 的 expert GEMM(general matrix multiplication,通用矩阵乘法)要同时检查语义、布局、向量化和线程划分。
标量循环与批量计算
标量循环一次处理一个元素。对很小的算子,循环控制、下标计算和解释器派发本身就可能占据时间。
数组接口把同一项操作作用于全部元素的意图直接交给数组库。这样 NumPy、PyTorch 或更底层的库才能选择连续内存访问、线程、SIMD 和专用矩阵实现。
NumPy 用户指南关于数组运算的说明(译)
NumPy 的核心对象是同类型元素组成的多维数组。许多运算逐元素应用于数组,并由底层已编译代码执行。1
# x 的形状为 (batch, hidden),scale 和 bias 的形状为 (hidden,)
y = x * scale + bias
上式表示每个 batch 行使用同一组 scale 与 bias。先把这个语义和 shape 写清,再谈性能。
如果 scale 实际是 (batch, 1),广播方向就变了。表达式若被拆成多个临时数组,内存流量也会变化。数组写法消除了 Python 层逐元素循环,底层是否生成融合 kernel 仍取决于运行时。
从 Python 循环到数组表达
# 逐元素循环。解释器每轮处理一次索引、取值和赋值
for i in range(x.shape[0]):
    for j in range(x.shape[1]):
        y[i, j] = x[i, j] * scale[j] + bias[j]

# 批量表达。把迭代空间交给数组库
np.multiply(x, scale, out=y)
y += bias
第二段仍可能两次扫描 y,但循环控制和逐元素解释已经交给已编译代码。只有 profile 显示中间数组的分配或读写占了主要时间,再考虑 out=、框架融合、JIT(Just-In-Time compilation,即时编译)或自定义 kernel。
数组表达式先提供了便于检查的基线。手写循环应当是测量之后的选择。
数据依赖
向量化和线程并行都依赖一个前提:把迭代调换顺序后,结果仍然相同。检查循环时,应直接写出第 i 次迭代读写哪些下标;循环变量不同并不等于访问的数据独立。
/* 迭代 i 写 y[i],只读 x[i]、scale[i]:通常独立。 */
for (int i = 0; i < n; ++i)
  y[i] = x[i] * scale[i];

/* 迭代 i 读取前一轮写出的 a[i-1]:存在循环携带依赖。 */
for (int i = 1; i < n; ++i)
  a[i] = a[i - 1] + x[i];
第二段是前缀和的一种形式。第 i 轮必须等到第 i-1 轮写完,普通 SIMD 循环无法直接保持这条顺序。并行程序要使用 parallel scan(并行扫描)等专门算法,或保留这段串行依赖。
归约也会合并多个迭代的结果,但加法、最大值等操作可以按树形结构分层处理。浮点加法的舍入顺序会随这棵树改变,后文还会说明如何验证。4
循环并行性的条件
常见阻碍可以归为四类。
| 阻碍 | 示例 | 正确的处理方向 |
|---|---|---|
| 写后读依赖 | a[i] 依赖 a[i-1] |
改用 scan、波前或分阶段算法 |
| 多迭代写同一位置 | hist[key[i]]++ |
私有直方图、原子操作或分桶 |
| 指针别名不确定 | f(float *a, float *b) |
核对调用约定。仅在不重叠时使用 restrict |
| 不规则控制流 | 每个元素走不同长路径 | 分桶、掩码或保留标量路径 |
C 的 restrict 用来告诉编译器:在这次函数调用中,两个指针所代表的可修改数组不会重叠。编译器据此可以少做保守的别名检查,并更容易把循环向量化。
例如 SAXPY 的输出 y 会被读写,输入 x 只读。若调用者保证两块数组各自独立,可以把这个约定写进函数签名。
void saxpy(int n, float a,
            const float *restrict x,
            float *restrict y) {
  for (int i = 0; i < n; ++i)
    y[i] = a * x[i] + y[i];
}

float x[1024], y[1024];
saxpy(1024, 2.0f, x, y); // 合法:x 与 y 是两块不同数组下面的调用则违反了这份承诺。y 同时作为只读的 x 和可写的 y 传入;即使某次编译运行看起来结果正常,优化器也可以依据 restrict 进行不适用于这个调用的重排。
saxpy(1024, 2.0f, y, y); // 错误用法:两个 restrict 访问范围重叠因此,restrict 适合用在数据所有权清楚的内层接口。添加后应保留不带 restrict 的参考实现,用不重叠和重叠两类输入分别检查调用点,并查看向量化报告是否确实改变。5
循环融合、拆分与数据布局
融合两个循环可减少中间数组写回和下一轮重新读取。
/* 两次完整扫描 x、tmp、y。 */
for (int i = 0; i < n; ++i) tmp[i] = f(x[i]);
for (int i = 0; i < n; ++i) y[i] = g(tmp[i]);

/* 若 tmp 不再被其他代码观察,可融合。 */
for (int i = 0; i < n; ++i) y[i] = g(f(x[i]));
融合会减少中间数组的读写,也可能扩大寄存器活跃范围、增加分支,或破坏原来的 SIMD 条件。
拆分循环有时更有利。把边界处理、罕见分支或不同数据类型移出热点后,主体循环会更规整。最终选择应由 profile 与向量化报告支持。
数据布局同样决定连续性。AoS(array of structures)适合按对象读取全部字段。SoA(structure of arrays)让同一字段连续,常更适合按字段的 SIMD 或 GPU 计算。选择布局前,先画出 GPU warp(通常由 32 个线程组成的硬件调度组)或向量 lane 在内层读取哪些地址。
NumPy 与数组编程
NumPy 从最后一个维度开始比较两个 shape。维度长度相等、其中一个长度为 1,或某个数组缺少这个维度时,两个数组可以参与同一次逐元素运算。长度为 1 的维度在语义上被扩展;它通常不需要真的复制出完整数组。3
广播与数组形状
x = np.zeros((32, 128))
scale = np.ones((128,))       # 对应最后一维 hidden
y = x * scale                 # 结果为 (32, 128)

row_scale = np.ones((32, 1))  # 对应 batch 维
z = x * row_scale             # 同样是 (32, 128),语义不同
下面的示意图把长度为 1 的维度怎样参与逐元素运算画出来。它对应的是 shape 的逻辑扩展,而不是一段必须写出的复制循环。
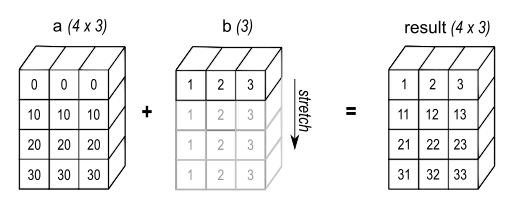
NumPy User Guide 的图展示广播后的逻辑对应关系。具体实现通常不需要复制完整数组。
在 MoE 中,tokens、experts、hidden、intermediate 的顺序不应依靠记忆。为每个张量在代码旁写出 shape,在小输入上打印一两个切片,并用断言检查。错误的广播往往不会报错,却会生成数值合理、形状正确但语义错误的结果。
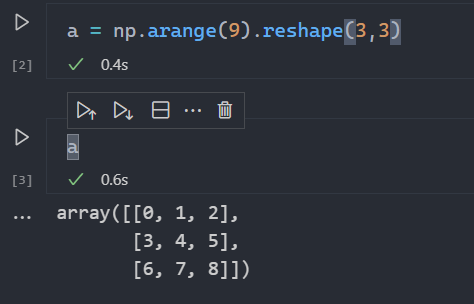
reshape 是否复制数据取决于原数组布局和目标形状。对性能敏感代码要区分逻辑 shape 与实际连续性。1
切片表达二维邻居求和
二维 stencil 可以用重叠切片表达内部格点的邻居和。
out[1:-1, 1:-1] = (
    a[:-2, 1:-1] + a[2:, 1:-1] +
    a[1:-1, :-2] + a[1:-1, 2:]
)
它保留了“内部点读取四个邻居”的数学结构,避免 Python 级双重循环。右侧可能形成多个临时数组,并对 a 进行多次扫描。规模扩大后,C/CUDA 实现还要处理边界格点、缓存分块和线程到二维坐标的映射;数组表达适合作为清晰的正确性基线。
矩阵乘法与 BLAS
矩阵乘法是数值计算中最成熟的基础算子之一。调用 np.matmul、BLAS、oneDNN 或框架库时,库会根据设备选择 packing、多级缓存分块、向量化、线程划分以及可能的矩阵单元路径。Netlib 对 BLAS 的定位正是为这类基础线性代数操作提供可复用的标准接口。6
手写三重循环适合学习下标、数据复用和结果验证。课程没有要求实现内部 kernel 时,经过调优的库通常应作为性能基线。
# A: (m, k), B: (k, n), C: (m, n)
C = A @ B
调用库前仍需确认 dtype、布局、leading dimension、batch 维和是否意外触发复制。一次 transpose 或非连续 slice 可能使库先执行 layout conversion;对小矩阵,调用和转换成本也可能压过计算本身。
SIMD 指令与向量寄存器
SIMD 寄存器一次容纳多个同类型元素。以 256-bit 向量为例,可放 8 个 float 或 4 个 double;512-bit 向量可放 16 个 float 或 8 个 double。一条向量加法、乘法或 FMA(fused multiply-add,融合乘加)会在各 lane 上执行相同操作。可用指令由 ISA(instruction set architecture,指令集架构)决定;Intel 的指令参考把每条 intrinsic 对应的元素类型和目标指令列得很清楚,实际吞吐还会受加载、存储、依赖、缓存和尾部处理影响。
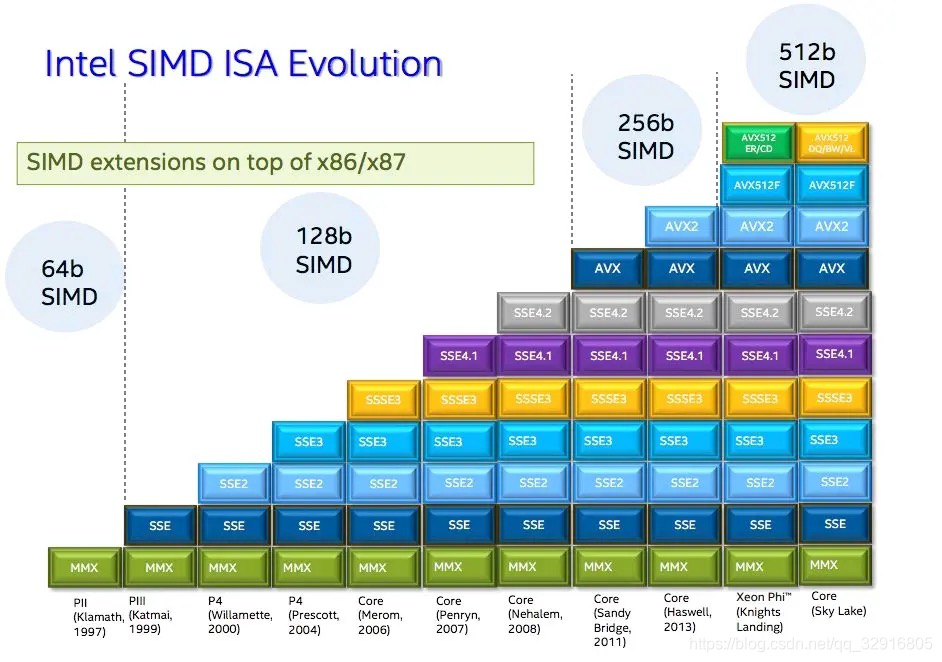
图展示 ISA 演进。数据供给、频率、指令组合和问题规模都会影响实际速度。7
点积、FMA 与归约
点积包含逐元素乘法与求和。FMA 在一次舍入中计算 \(a\times b+c\),常能提高吞吐和数值行为的一致性;向量化后的部分和仍需归约为标量。
float sum = 0.0f;
for (int i = 0; i < n; ++i)
sum += a[i] * b[i];编译器可将其拆为多个向量累加器,最后做水平求和。加法顺序改变后,浮点结果可能与标量版本最后几位不同;正确性测试应采用题目定义的绝对或相对误差,并记录允许的数值范围。8
加速比的限制
一个 float 向量有 16 个 lane 不代表循环自动快 16 倍。若每轮只做一次加法并加载、存储多个数组,内存带宽可能先饱和;若有长依赖链,单个累加器的延迟限制吞吐;若数组很短,调用和尾部处理占比很高;若存在分支,部分 lane 可能做无效工作。向量宽度是资源,只有独立工作和数据供给足够时才会转化为速度。
自动向量化
自动向量化是首选基线。编译器知道目标 ISA、调度模型和安全边界,能在不牺牲可移植性的前提下生成不同机器的代码。GCC 可输出成功与失败的向量化报告;Clang 可使用 -Rpass=loop-vectorize 等选项。报告是定位工具,最后仍要用时间与正确性验证。5
gcc -O3 -march=native -g \
  -fopt-info-vec-optimized -fopt-info-vec-missed \
  kernel.c -o kernel
读懂向量化报告
loop vectorized表示某个循环已生成向量版本,仍需看它是否处在热点。possible aliasing表示编译器无法证明指针不重叠。检查 API 约定与调用点。not vectorized: unsafe dependent memory operations表示需要检查循环携带依赖或间接写入。control flow in loop表示可将罕见分支移出主体,或评估掩码是否合适。
不要把 #pragma omp simd 当作性能注释。它向编译器声明迭代可以按 SIMD 语义重排;若声明不成立,程序可能产生错误结果。先写出依赖证明,再添加指令。4
尾部元素与掩码
数组长度很少恰好是向量宽度整数倍。编译器可以生成标量 remainder loop,也可以使用掩码向量指令。手写 intrinsic 时必须确保无效 lane 不越界读取和写入。
下面这张图解释的是 intrinsic 名称,不是 mask 寄存器中 0/1 位的分布。名称中的 _mask 表示该函数有掩码版本;其他片段分别提示向量宽度、操作和元素类型。实际哪些 lane 有效,仍要由调用时传入的 mask 值决定。
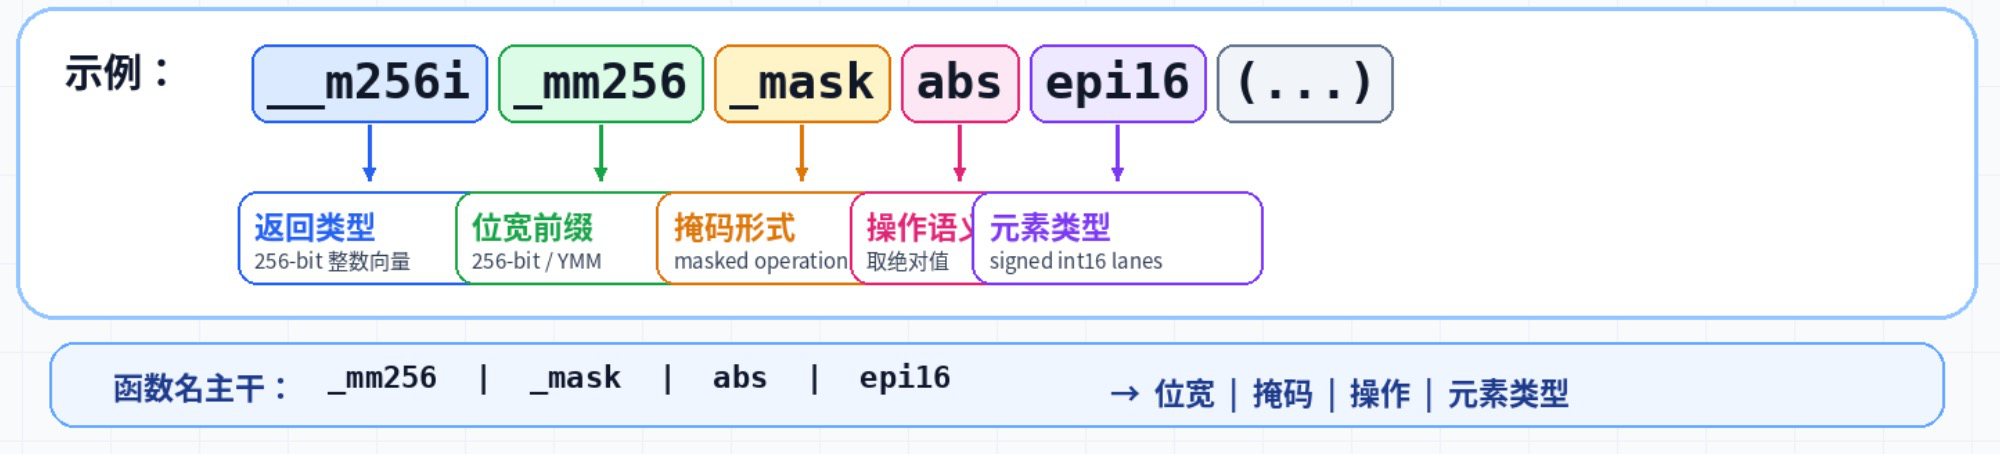
阅读 intrinsic 时,名称只能帮助判断接口大意;掩码加载、计算和存储的精确语义仍应查看对应文档。
SIMD intrinsic
intrinsic 是 C/C++ 中对应特定 SIMD 指令的接口。它适合已证明为热点、形状稳定的内层循环。使用 intrinsic 前,检查目标机器是否支持该 ISA、标量或自动向量版本是否正确、尾部、对齐、别名和浮点误差是否已有测试。7
#include <immintrin.h>

for (int i = 0; i + 8 <= n; i += 8) {
  __m256 vx = _mm256_loadu_ps(x + i);
  __m256 vy = _mm256_loadu_ps(y + i);
  __m256 vz = _mm256_fmadd_ps(vx, va, vy);
  _mm256_storeu_ps(y + i, vz);
}
for (; i < n; ++i) y[i] = a * x[i] + y[i];
loadu 表示允许未对齐地址,连续访问和正确边界仍是更早需要保证的条件。若同一可执行文件要运行在不同 ISA 的机器上,应采用编译器多版本化、运行时特性检测或保留通用路径,确保启动时选择可执行的指令路径。
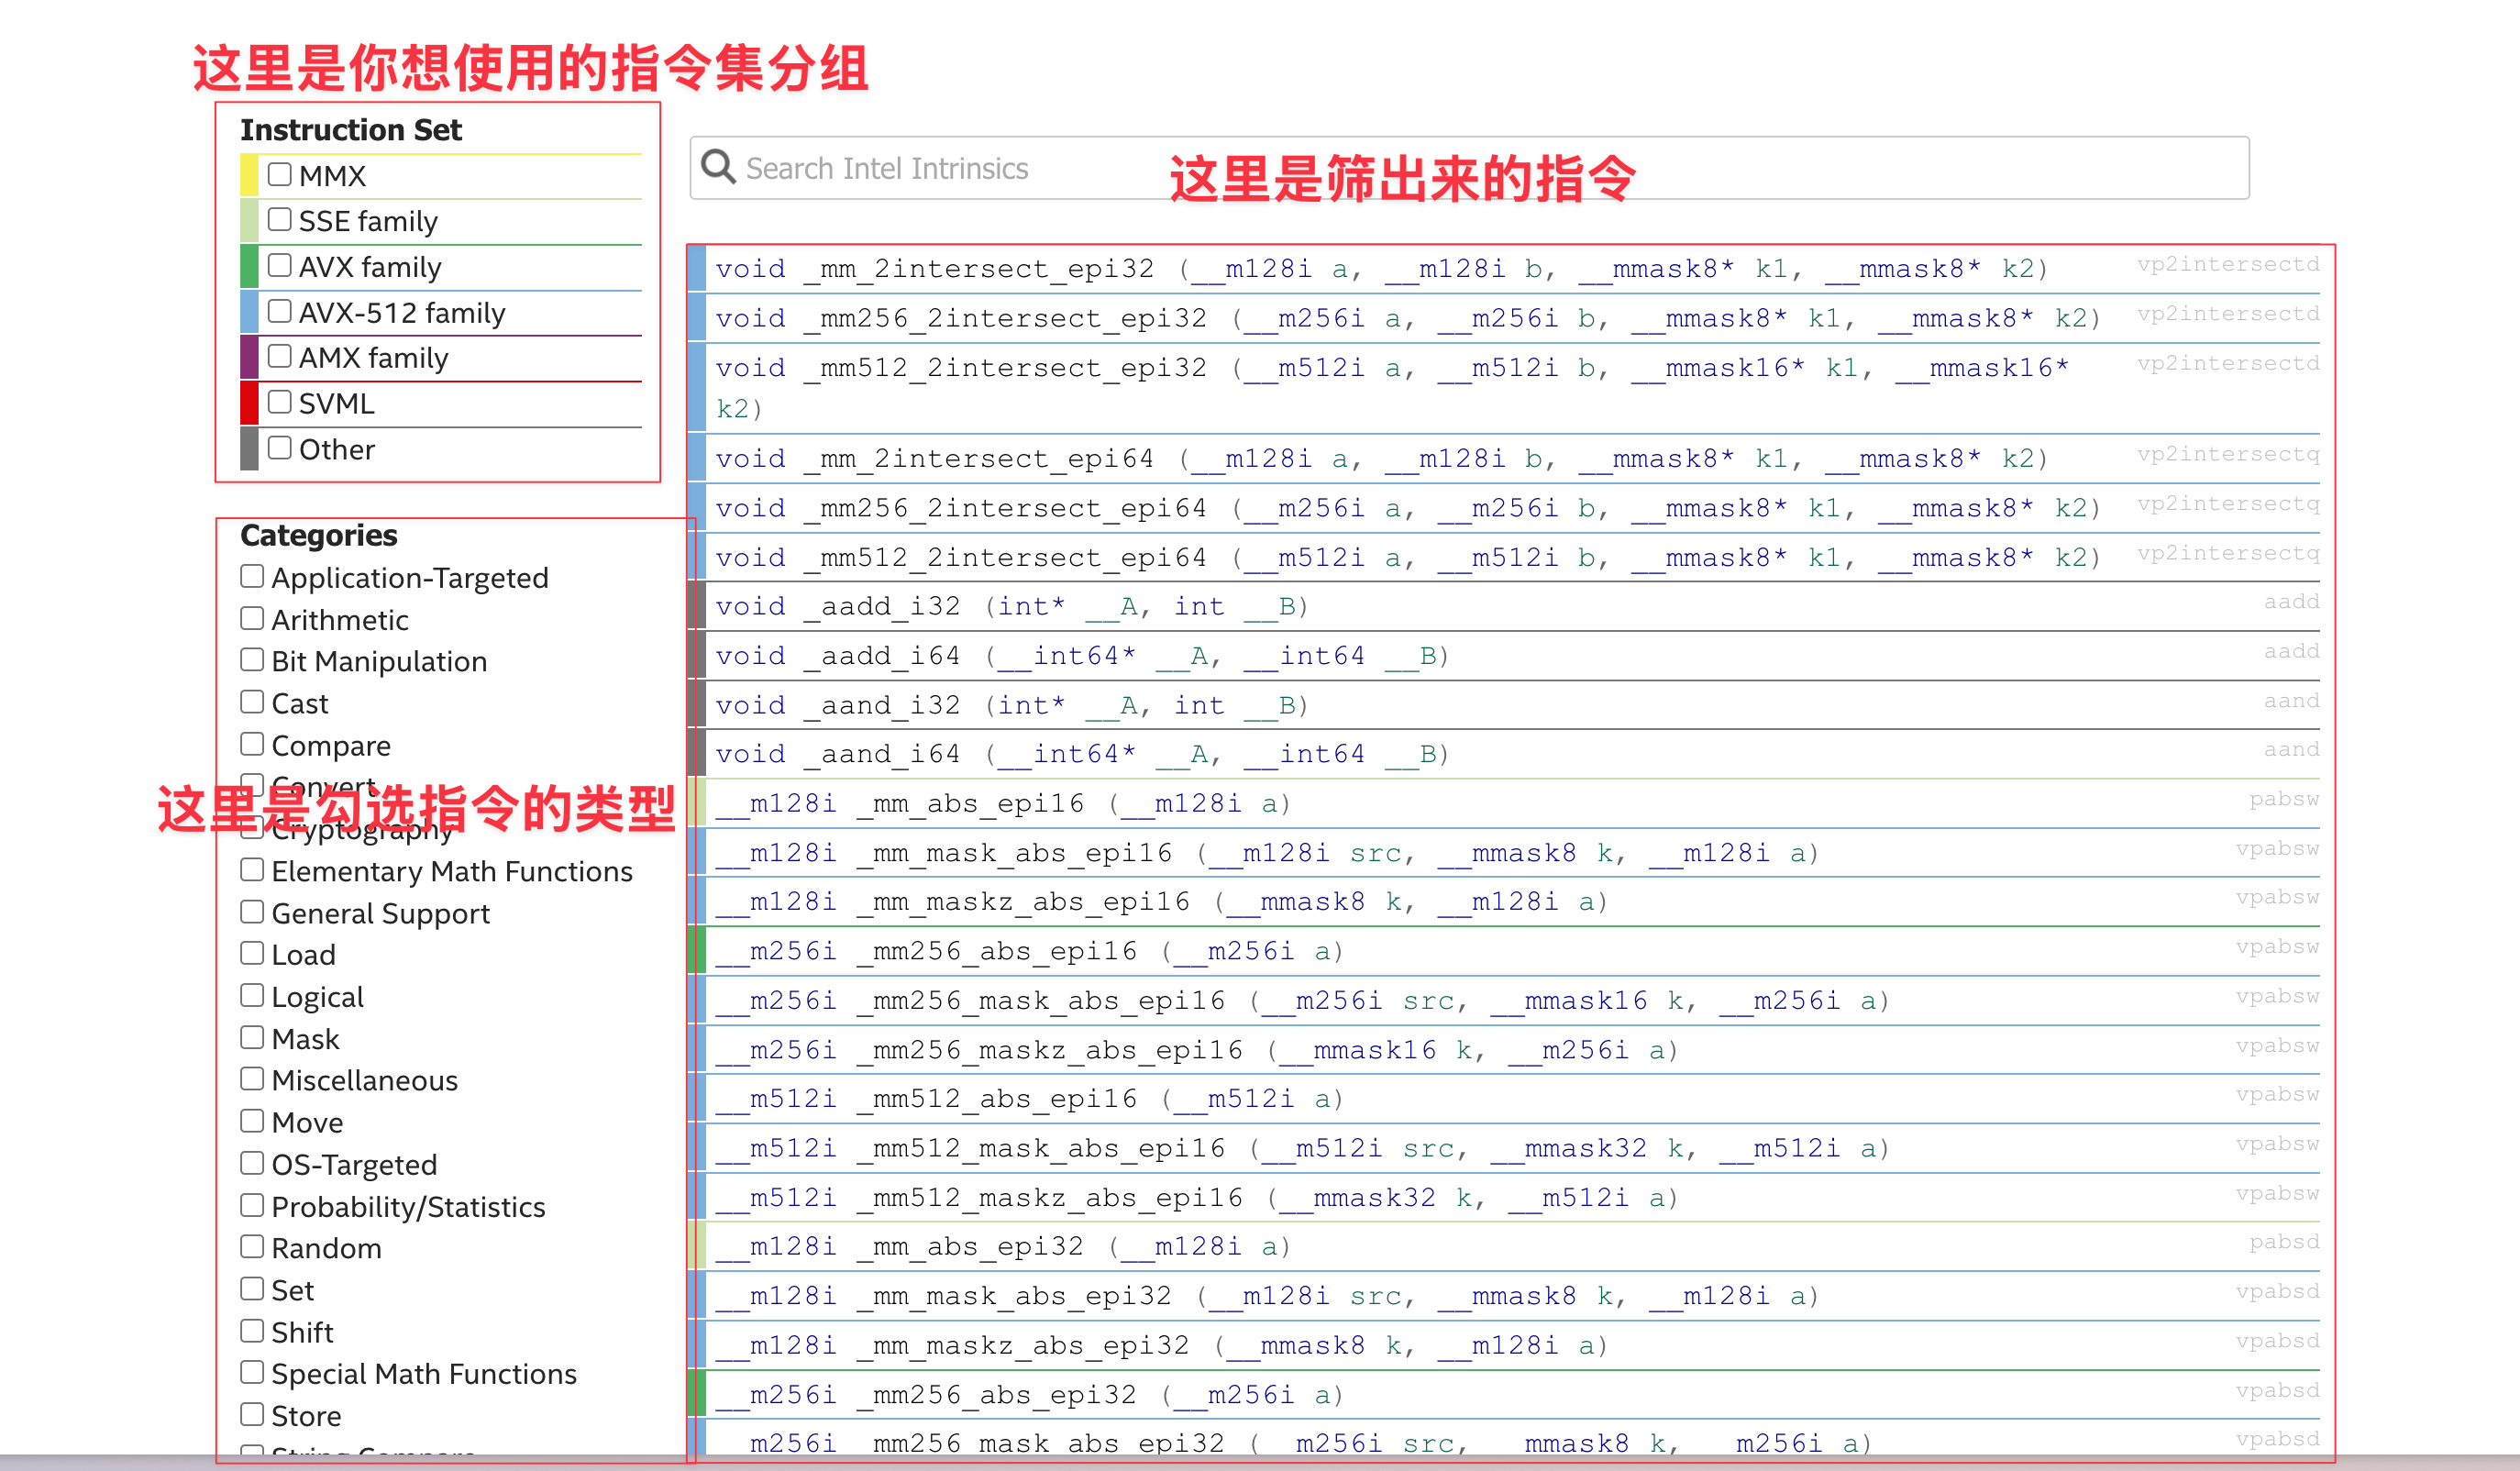
查 intrinsic 时应同时阅读参数、mask、舍入和数据类型语义。名称相似的 intrinsic 也可能行为不同。
矩阵乘法与缓存分块
分块要从矩阵乘法本身的重复读取开始理解。设
其中 \(M\)、\(N\)、\(K\) 分别是输出行数、输出列数和求和维度。一个输出元素的计算是
例如计算 C[0][0] 和 C[0][1] 时,两者都会读取 A[0][k]。计算 C[0][0] 和 C[1][0] 时,两者都会读取 B[k][0]。矩阵乘法本身包含大量这样的重复使用;问题在于,CPU 能否在下一次使用前把这些数据留在缓存里。
先看最直观的三重循环。它一次完成一个 C[i][j],每次沿 \(k\) 累加。
for (int i = 0; i < M; ++i)
  for (int j = 0; j < N; ++j)
    for (int k = 0; k < K; ++k)
      C[i*N + j] += A[i*K + k] * B[k*N + j];
当矩阵很大时,计算完 C[i][j] 再去计算相邻输出,先前读过的 A 或 B 行可能已经被其他访问挤出缓存。分块(blocking 或 tiling)把大矩阵的一个连续子区域当作当前工作范围,让这一区域的数据在离开缓存前参与更多次乘加。
设 \(BM=BN=BK=2\)。现在先计算输出块 C[0:2, 0:2],它包含四个输出元素。处理 \(k=0,1\) 时,只需要下面三个小块:
A[0:2, 0:2]   B[0:2, 0:2]   →   更新 C[0:2, 0:2]
A[0:2, 2:4]   B[2:4, 0:2]   →   继续累加同一个 C[0:2, 0:2]
第一个 \(2\times2\) 的 A 块会参与同一输出块的两列计算;第一个 \(2\times2\) 的 B 块会参与两行计算。块越大,单次加载可服务的乘加越多;但块也要能和正在累加的 C 一起留在缓存或寄存器中。
下面的循环直接把这种顺序写出来。ii、jj、kk 是三个块在原矩阵中的起点;BM、BN、BK 是块在 \(M\)、\(N\)、\(K\) 三个方向的大小。
for (int ii = 0; ii < M; ii += BM)
  for (int jj = 0; jj < N; jj += BN)
    for (int kk = 0; kk < K; kk += BK)
      for (int i = ii; i < min(ii + BM, M); ++i)
        for (int k = kk; k < min(kk + BK, K); ++k) {
          double aik = A[i*K + k];
          for (int j = jj; j < min(jj + BN, N); ++j)
            C[i*N + j] += aik * B[k*N + j];
        }
外层 ii,jj 固定当前 C tile,内层 kk 依次累加各段 \(K\)。aik 放在寄存器中,在当前 j 块里反复使用;B[k][j] 与 C[i][j] 都沿 C/C++ 行主序的连续方向访问。边界处的 min(...) 处理矩阵大小不能被块大小整除的情况。
分块不会改变 \(2MNK\) 次浮点操作。它改变的是访问顺序和数据复用:同一份 A、B、C 数据在更短的时间间隔内再次使用,缓存行和寄存器因而能服务更多乘加。成熟 BLAS 库还会在这个基础上加入 packing、多级缓存块、向量寄存器 tile 和线程划分;手写三重循环的价值是先看清这些复用来自哪里。
低精度矩阵乘法的字节数、累加精度和数据布局
INT8、FP16、BF16 等格式可以减少权重和激活的存储、传输与加载字节数,也可能进入 VNNI、AMX 或 Tensor Core 路径。INT8 是 8 位整数;FP16 和 BF16 分别是 IEEE 半精度和 bfloat16 浮点格式。VNNI(Vector Neural Network Instructions,向量神经网络指令)加速低位整数点积;AMX(Advanced Matrix Extensions,高级矩阵扩展)提供 tile 矩阵寄存器;Tensor Core 是 NVIDIA GPU 上执行特定低精度矩阵乘加的硬件单元。量化实现应说明输入和权重如何缩放、乘加累加器采用何种精度、输出何时反量化。低精度输入与高精度累加是常见组合,具体规则以库和硬件 API 为准。
设 \(x\approx s_x q_x\)、\(w\approx s_w q_w\),则线性层的近似输出可写成
这里 \(x\) 是输入激活向量,\(w\) 是权重矩阵,\(y_i\) 是第 \(i\) 个输出元素。下标 \(j\) 沿输入维度求和。\(q_x\)、\(q_w\) 是量化后的整数值,\(s_x\)、\(s_w\) 是把整数格点还原到浮点范围的缩放系数。式子先在整数域累加 \(q_{x,j}q_{w,ij}\),再乘两个 scale 恢复近似浮点结果。实际 kernel 还要选择累加器位宽,避免大量 INT8 乘积相加后溢出。
scale 可以按 tensor、channel 或 group 设置。粒度越细,量化误差通常越容易控制,scale 元数据与处理开销也越大。Lab 2 的 W8A8/MoE 场景还要关注每个 expert 实际收到的 token 数。expert batch 很小时,重排、量化或调用开销可能超过矩阵核收益。
VNNI、AMX 与矩阵 Tile
VNNI 将多组小整数乘法及累加组织为高密度点积,适合量化矩阵乘法的内层。数据类型正确还不够,内存中元素的打包顺序、矩阵 layout 和累加器宽度都必须符合指令或库的约定。9
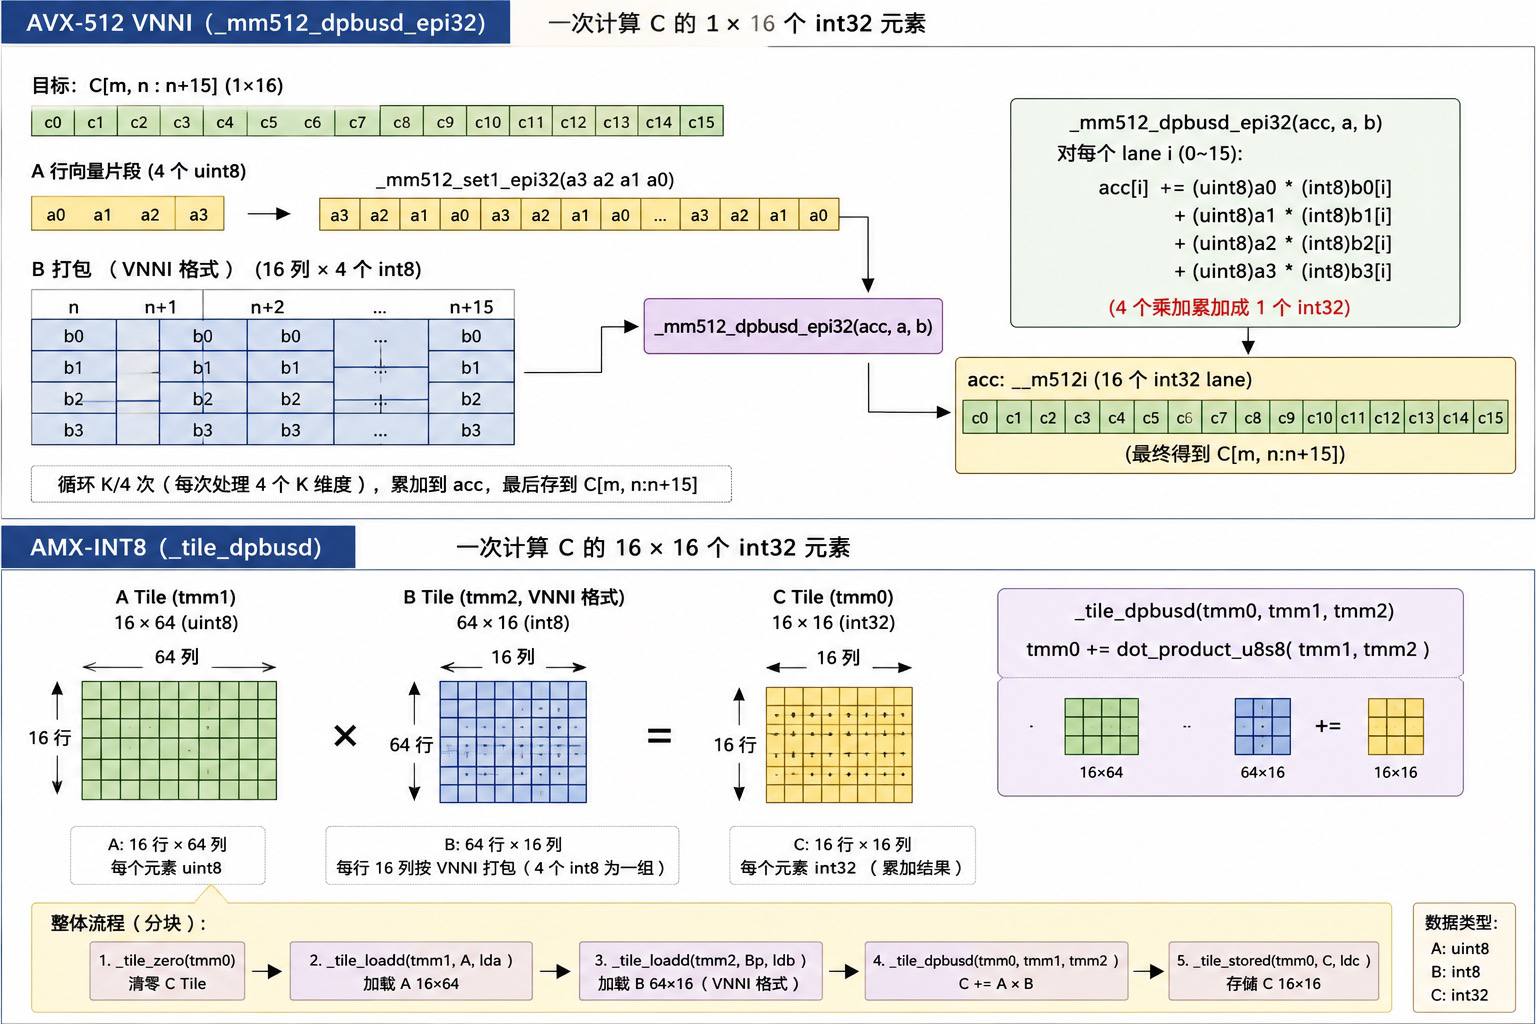
VNNI 将多项整数乘加压缩到高吞吐指令路径。图中元素类型与 intrinsic 的精确符号应以 Intel Intrinsics Guide 为准。
AMX 使用 tile 寄存器表达更大的矩阵块计算。使用 AMX 仍要处理 tile 配置、load/store、缓存复用和形状边界。对小而变化频繁的调用,配置和数据准备可能无法摊薄。实际项目可优先使用支持 AMX 的 BLAS/oneDNN,手写 tile 更适合作为受控实验。9
固定宽度 AVX 与可伸缩 SVE
AVX(Advanced Vector Extensions,高级向量扩展)的向量宽度随指令集固定。ARM SVE(Scalable Vector Extension,可伸缩向量扩展)的硬件向量长度可变,程序用谓词标记本轮有效元素。两种模型都要求正确处理尾部。10
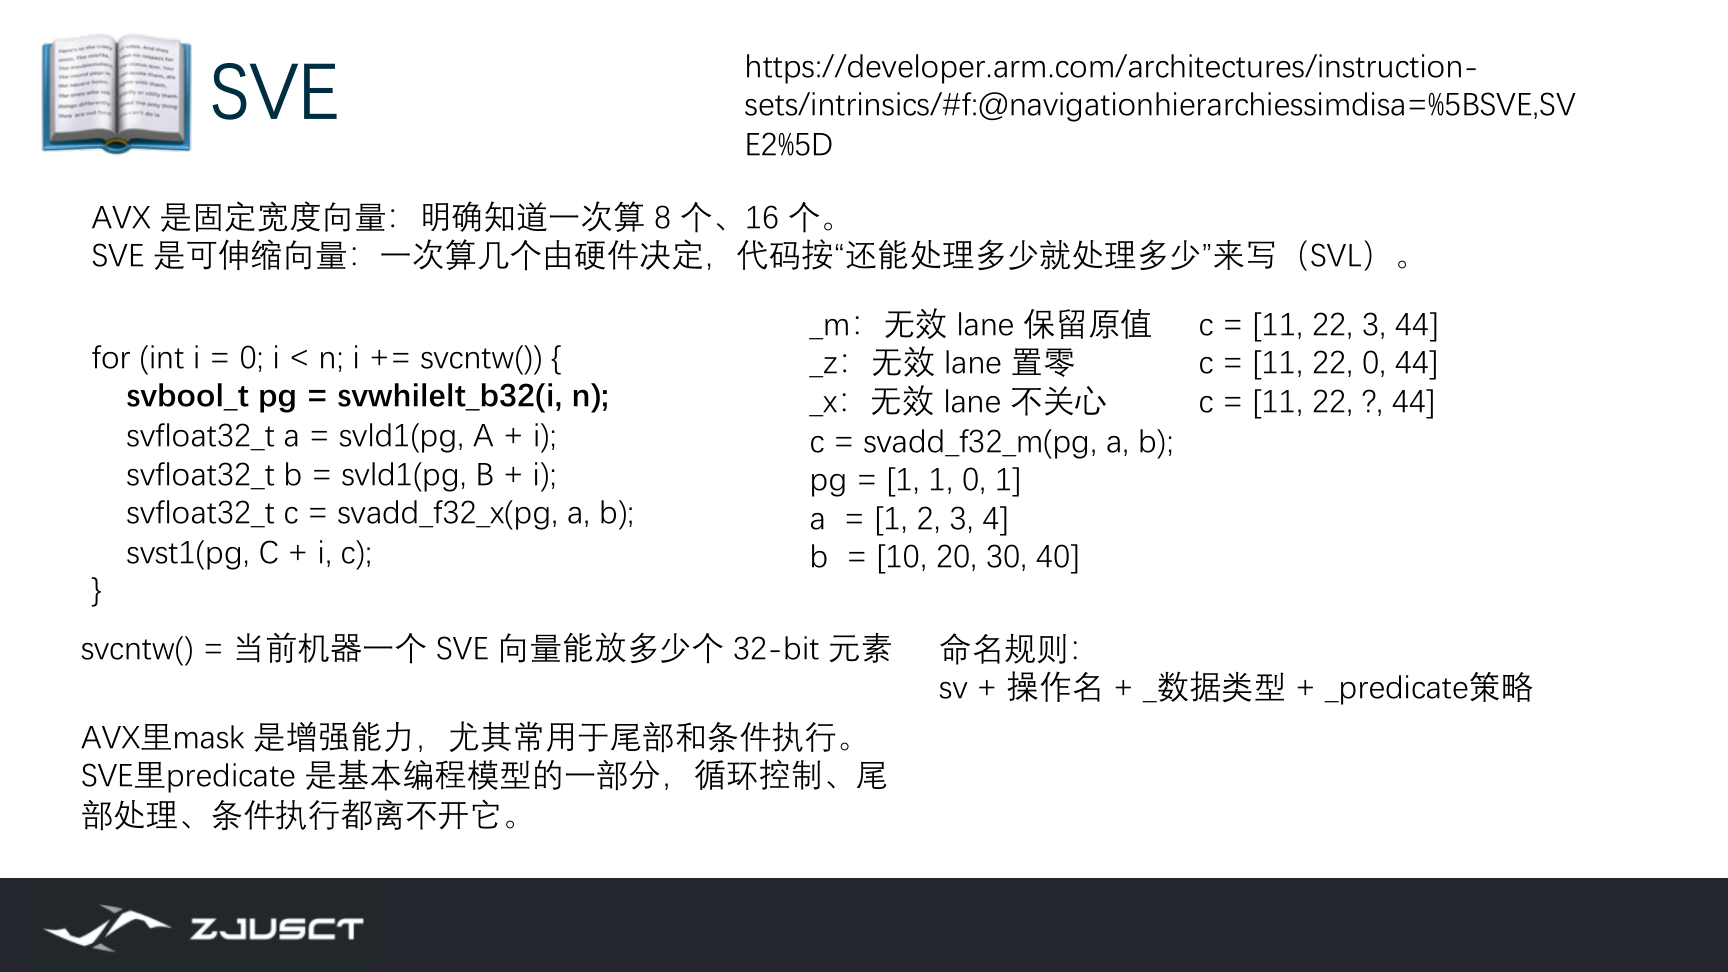
可伸缩向量代码通过谓词处理本轮有效元素,避免把某个硬件宽度写死在算法中。
RISC-V 向量扩展(RVV)
RVV(RISC-V Vector Extension,RISC-V 向量扩展)也采用向量长度无关的思想。程序通过 vsetvl 根据剩余元素数、元素宽度(SEW,Standard Element Width)和寄存器组长度(LMUL,Vector Length Multiplier)设置本轮实际向量长度,再处理这批元素。它与 SVE 一样有利于跨不同实现复用循环结构,但仍要明确掩码、规约、类型转换和目标平台的扩展支持。11
基准测试
基准测试应把结果验证和运行计时分开。先用小规模数据、不同 shape 和边界输入同参考实现比较;然后用代表性大输入预热并重复计时。记录里应包含编译器、目标 ISA、线程数、CPU 绑定、输入形状,以及是否把量化、重排等准备阶段算进时间。12
结果验证与计时
1. 固定随机种子和输入形状,保留参考输出或误差判据。
2. 单独测准备、重排、量化、核心 kernel 与端到端流程。
3. 预热后重复运行,记录原始样本与中位数。
4. 对比标量、自动向量化、intrinsic、BLAS/库路径。
5. 修改后重新检查误差、内存越界和线程数设置。
对齐与别名
对齐、restrict 与预取都是底层工具。先保证连续布局、没有错误别名,并确认循环处在热点。profile 和报告显示相应问题时再调整。对齐假设不成立时,手写 aligned load 可能直接崩溃。错误的 restrict 也可能静默地产生错误答案。
浮点归约与可重复性
SIMD、OpenMP 和不同 BLAS 可能以不同树形顺序合并部分和。浮点加法不满足严格结合律,因此结果最后几位会变化。对数值敏感任务,可使用更高精度累加、分层归约或补偿算法。对机器学习算子,按任务的绝对或相对误差、下游指标判断。系统验证应覆盖多次运行和多种输入形状。8
练习
- 为 Lab 2 的一个张量写下 shape、连续维度和每个维度的语义。
- 用 NumPy 写一个广播表达,并给出两个会改变广播方向的 shape 反例。
- 为一个 SAXPY 或点积循环开启 GCC 向量化报告,解释一个成功或失败原因。
- 比较自动向量化与 BLAS 的正确性和计时;记录 CPU、编译选项、输入和线程数。
- 检查一个 INT8 内核的 scale 形状、累加器类型、重排位置与尾部处理。
参考答案
- 例如 expert 输入可以写成
[tokens_for_expert,H]。最后一维H通常连续;第一维表示被路由到该 expert 的 token 数。记录 shape 时还要写清 token 是否已按 expert 重排。 - 设
x.shape=(32,128)。scale.shape=(128,)会沿 batch 维广播;row_scale.shape=(32,1)会沿 hidden 维广播。两者输出都可能是(32,128),但数值含义不同。 - GCC 可使用
-O3 -fopt-info-vec-optimized -fopt-info-vec-missed。若报告出现possible aliasing,先检查两个指针是否可能重叠;若出现循环携带依赖,应检查下标和归约方式。 - 正确性可比较最大绝对误差或相对误差。计时应固定输入、CPU、线程数和编译选项;先预热,再重复运行并记录中位数。BLAS 通常是高性能基线,而不是仅供比较的普通函数。
- 记录 scale 是 per-tensor、per-channel 还是 per-group;确认乘加使用的累加器类型;确认权重 packing 发生在何处;确认最后一个 K 或 N tile 的尾部不会越界。Lab 2 中这些信息共同决定量化路径是否既正确又高效。
-
NumPy, NumPy user guide, https://numpy.org/doc/stable/user/. ↩↩↩
-
Intel, Intel® 64 and IA-32 Architectures Optimization Reference Manual, https://www.intel.com/content/www/us/en/developer/articles/technical/intel-sdm.html. ↩↩
-
NumPy, Broadcasting, https://numpy.org/doc/stable/user/basics.broadcasting.html. ↩↩
-
OpenMP Architecture Review Board, OpenMP API Specification, https://www.openmp.org/specifications/. ↩↩
-
GCC, Optimize Options: Vectorization, https://gcc.gnu.org/onlinedocs/gcc/Optimize-Options.html. ↩↩
-
Netlib, BLAS (Basic Linear Algebra Subprograms), https://netlib.org/blas/. ↩
-
Intel, Intrinsics Guide, https://www.intel.com/content/www/us/en/docs/intrinsics-guide/index.html. ↩↩
-
IEEE, IEEE Standard for Floating-Point Arithmetic (IEEE 754), https://standards.ieee.org/ieee/754/6210/. ↩↩
-
Intel, Intel® Advanced Matrix Extensions, https://www.intel.com/content/www/us/en/developer/articles/technical/intel-amx.html. ↩↩
-
Arm, Scalable Vector Extension, https://developer.arm.com/Architectures/Scalable%20Vector%20Extension. ↩
-
RISC-V International, RISC-V Vector Extension, https://docs.riscv.org/reference/isa/unpriv/v-st-ext.html. ↩
-
Google, benchmark library, https://github.com/google/benchmark. ↩
 本站总浏览