07-08 下午:HPC 中的计算机系统 II
前一节说明了一台节点里的处理器、内存和线程。本节把视野放到集群:程序离开登录节点后,如何获得节点,怎样启动多个进程,数据又经过哪些软件和存储层。
HPC(High-Performance Computing,高性能计算)系统把计算节点、高速网络、存储系统和调度器放在同一套运行环境里。程序的计算部分也许只占几行代码,但一次实验的结果还取决于资源请求、进程布局、数据访问方式和运行时环境。
Slurm 文档的说明(译)
Slurm 是开源的集群管理和作业调度系统。它为用户作业分配节点,启动、监视任务,并记录资源使用情况。1
HPC 系统与工作负载
集群中的部件分工不同。先知道数据和计算会落在哪里,后面的 Slurm 参数、MPI 启动命令和 I/O 优化才有明确含义。
| 部件 | 日常用途 | 与实验有关的限制 |
|---|---|---|
| 登录节点 | 编辑、编译、提交、查看日志 | 不运行长时间的大计算 |
| 计算节点 | 执行调度器分配的 CPU 或 GPU 任务 | 节点和 CPU 数由 allocation 决定 |
| 高速互连 | 在 rank、GPU 或节点之间传输数据 | 小消息常受启动开销影响;大消息依赖带宽和拓扑 |
| 共享文件系统 | 保存源码、输入、结果和检查点 | 大量小文件会加重元数据服务负担 |
下面的图把这几类资源放到同一个组织示意中。先看计算、互连和存储的分工,后面再讨论调度和 I/O 的具体路径。
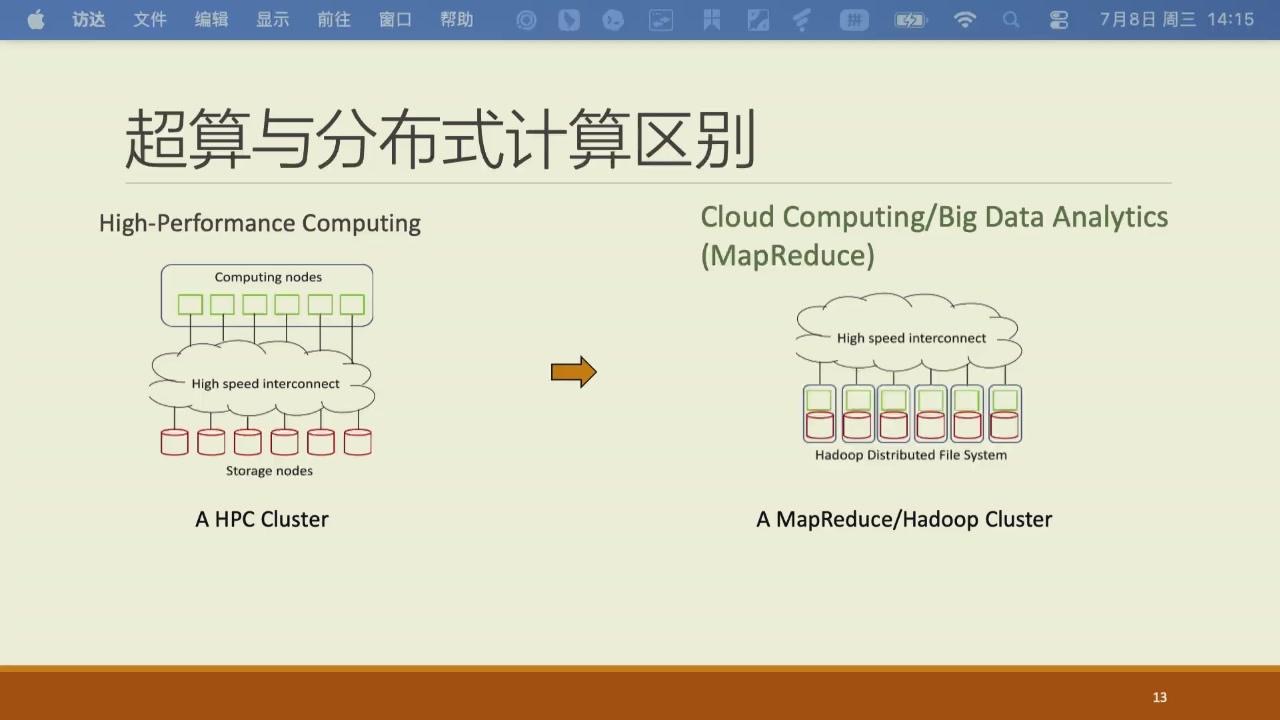
阅读此图时先区分三类资源。计算节点负责执行,互连负责节点间数据交换,存储服务负责长期保存数据。实际集群会按规模、存储系统和网络设备采用不同拓扑。
资源请求可以写成一个简单的乘法式。例如 2 个节点 × 每节点 4 个 rank × 每 rank 8 个 OpenMP 线程,表示一共有 8 个 MPI 进程,每个节点会使用 32 个 CPU 配额。这个数应同时对应 Slurm 参数、启动命令和 OMP_NUM_THREADS。
先把资源形状写在实验记录里
除了节点数,还应记录每节点的 rank 数、每个 rank 的线程数、GPU 数、线程绑定方式和输入规模。只写“使用 64 核”无法说明这 64 个 CPU 是 64 个进程、8 个进程各带 8 个线程,还是其他组合。
一次作业如何经过集群
一份脚本提交后,不会立刻在某台固定机器上执行。它先成为队列中的作业请求;调度器找到满足条件的资源后,才在选定的计算节点上启动程序。
登录节点用于编辑、编译、传输文件、加载软件环境和提交脚本。它是许多用户共同使用的入口,长时间计算应交给调度器分配的计算节点。
脚本写明节点数、任务数、每个任务需要的 CPU、GPU、内存和最长运行时间。Slurm 根据分区策略和当前资源情况安排作业。MPI(Message Passing Interface,消息传递接口)程序中的一个 rank 通常就是一个独立进程;Slurm 的 task 常用来启动这类进程。
srun 在分配到的节点上启动 task。一个 task 内还可以有 OpenMP 线程。程序从共享存储或节点本地盘读取输入,在计算时通过网络通信,最后写出日志、结果或检查点。
作业结束后,调度器保留状态、运行时间和资源使用记录。退出码为零只说明进程正常结束;数值结果仍要由程序自己的验证方式判断。
作业调度与资源形状
Slurm 把节点和其他可分配资源组织到 partition(分区)中。sbatch 提交批处理脚本,salloc 申请交互式资源,srun 在已经获得的 allocation(资源分配)中启动任务。排队时间取决于分区规则、优先级、申请规模、时间上限和当时的集群负载。5
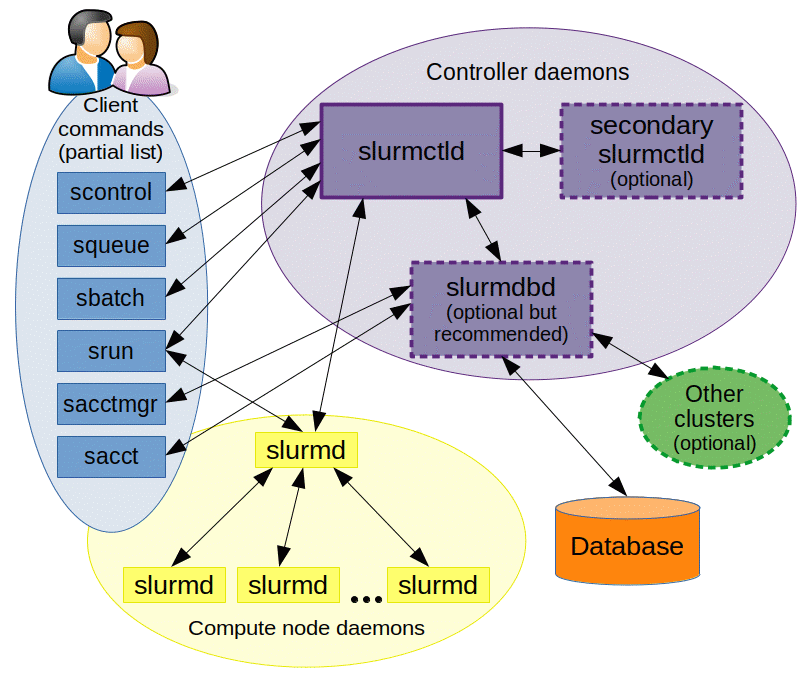
提交脚本时,控制端记录资源请求并寻找可用节点。作业开始后,节点上的 slurmd 配合启动命令创建实际任务。图中的数据库承担记账和管理工作,与每一次程序启动的计算路径分开。1
一个 MPI 加 OpenMP 的脚本可以从下面的形式开始。
#!/usr/bin/env bash
#SBATCH --job-name=matmul
#SBATCH --nodes=2
#SBATCH --ntasks-per-node=4
#SBATCH --cpus-per-task=8
#SBATCH --time=00:10:00
#SBATCH --output=logs/%x-%j.out
#SBATCH --error=logs/%x-%j.err

module purge
module load gcc openmpi
export OMP_NUM_THREADS="$SLURM_CPUS_PER_TASK"
srun --cpu-bind=cores ./solver input.dat
--ntasks-per-node=4 让每个节点启动 4 个 task;对 MPI 程序,这通常对应 4 个 rank。--cpus-per-task=8 为每个 rank 预留 8 个 CPU。OMP_NUM_THREADS 将 OpenMP 线程数限制在这份配额内。实际集群的 CPU 计数可能是物理核,也可能包括硬件线程,应以本集群规则为准。
这份脚本实际请求的是 \(2\times4=8\) 个 MPI rank,每个 rank 再使用 8 个 OpenMP thread。若分配到 nodeA 和 nodeB,rank 的布局可写成:
| 节点 | MPI rank | 每个 rank 的 OpenMP thread |
|---|---|---|
nodeA |
0, 1, 2, 3 | 8 |
nodeB |
4, 5, 6, 7 | 8 |
作业刚启动时,可以先把程序名换成下面这条检查命令。它应输出 8 行,其中每个节点名出现 4 次;rank= 从 0 到 7 各出现一次。
srun -n "$SLURM_NTASKS" \
  bash -c 'echo "$(hostname) rank=$SLURM_PROCID threads=$OMP_NUM_THREADS"'
若只看到一行输出,说明 task 数或启动命令没有对齐。若某行显示 threads=64,通常是 OpenMP 没有继承 OMP_NUM_THREADS=8,会超过 --cpus-per-task 的配额。
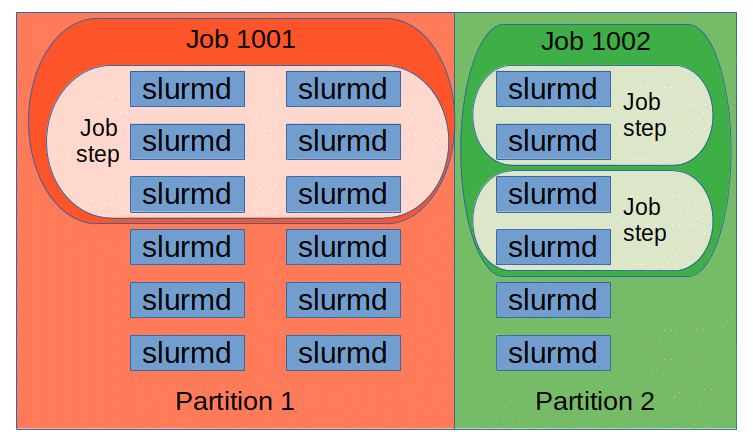
job 是提交后进入队列的对象。job step 是这个 job 内一次具体的启动步骤。理解这一区分后,就能解释为什么同一 allocation 内可以多次运行 srun,也能检查每次启动是否仍在申请到的资源范围内。1
作业脚本的三部分
批处理脚本同时包含资源说明、运行环境和启动命令。以 #SBATCH 开头的行由 sbatch 在提交时读取;module load 和 export 是作业开始后由 shell 执行的命令;srun 再把程序放到分配的节点上。6
可以先用小命令核对分配是否正确。
srun hostname
srun -n "$SLURM_NTASKS" bash -c 'echo "$SLURMD_NODENAME rank=$SLURM_PROCID"'
这比直接启动大型程序更容易发现节点数、rank 数或环境变量没有对上的问题。
查看作业状态
PD 表示 pending,作业还在等待资源或调度条件;R 表示 running。作业完成后,sacct 可以显示分配到的 CPU、最长常驻内存和退出码。
squeue -j JOBID -o "%.18i %.9T %.30R"
sacct -j JOBID --format=JobID,State,Elapsed,AllocCPUS,MaxRSS,ExitCode
COMPLETED 是调度状态,表示程序进程已正常退出。输出文件、误差检查和结果图仍然要由实验者查看。7
超算的软件栈
应用程序不会直接操作磁盘或网络硬件。一次读写会经过库、运行时、文件系统客户端和驱动;一次 MPI 通信也依赖 MPI 库、网络运行时和网卡驱动。模块系统的作用是让用户选择一组彼此匹配的编译器、MPI 库和数学库。8
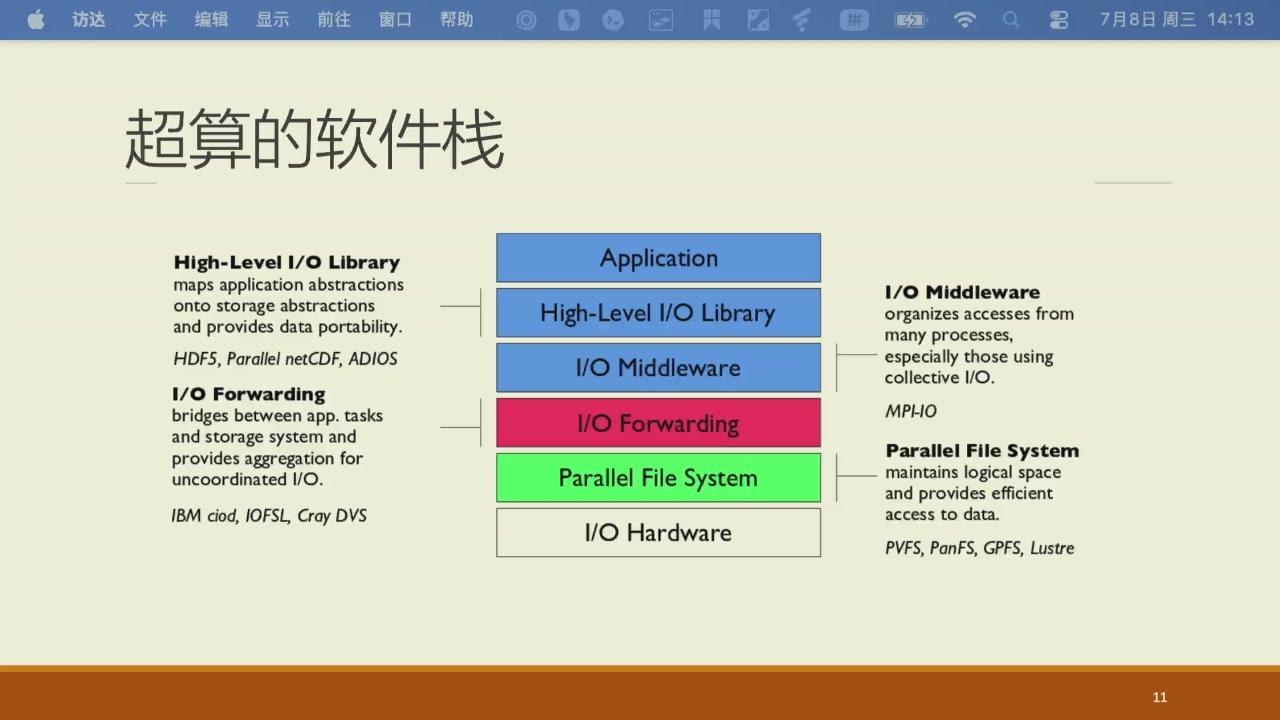
图中的 high-level I/O library 将应用接口映射到更底层的存储抽象;I/O middleware 可以协调多个进程的访问;I/O forwarding 位于应用任务与存储系统之间,用于聚合或转发 I/O;并行文件系统向上提供统一文件空间,向下使用实际存储硬件。普通 POSIX 读写常直接经过文件系统客户端,高层库和 forwarding 层则按应用部署选用。
在计算节点上,先用下面的命令确认当前软件环境。
module purge
module load gcc/13 openmpi/5
which mpicc
mpicc --showme:command
把 module list、编译器版本、构建命令和代码提交号写入日志。不同 MPI 实现、编译器和数学库可能生成不同的二进制;离开这些信息,性能数值很难复查。
存储系统中的文件位置
并行文件系统把一个文件的数据分散到多个存储目标,使多个客户端能同时访问不同部分。Lustre 文档把文件系统客户端、元数据服务和对象存储服务分别处理:目录、文件名和权限属于元数据;文件内容分布在对象存储目标上。9
文件能够打开时,路径解析和权限检查已经通过。高带宽读取还取决于文件大小、条带、并发客户端、访问模式和存储负载。
访问模式、条带与元数据
顺序读取一个足够大的文件时,条带(striping)可让数据分布在多个存储目标上,并行提供带宽。相反,许多 rank 同时创建、列举或打开小文件时,目录查询、权限检查和 inode 等元数据操作更容易先达到上限。9
| 访问方式 | 常见压力点 | 可以先检查的内容 |
|---|---|---|
| 少量大文件,连续读取 | 数据带宽 | 条带数、请求大小、并发读者数 |
| 每个 rank 写一个小文件 | 元数据服务 | 文件数、创建/关闭次数、目录层级 |
| 随机小块访问 | 延迟与缓存 | 请求粒度、访问顺序、是否需要聚合 |
将每个样本单独存成文件的数据集改为分片文件或容器格式前,还要确认训练读取器能否并行、失败后怎样恢复,以及课程工具是否支持这种格式。
检查点策略
检查点保存恢复计算所需的状态。数值程序通常至少需要保存迭代步和关键数组;训练程序还可能需要模型参数、优化器状态、随机数状态和数据读取进度。NERSC 的实践将写入流程和恢复流程作为同一项设计工作,运行前就应完成验证。10
checkpoint.tmp/ → 写完数据与元数据 → 校验 → 原子发布 checkpoint-0042/临时路径写完并校验后再发布,恢复程序只接受带完成标记的检查点,可以避免把半写入的数据当作有效结果。记录 I/O 时间时还要说明是否包含同步、所有 rank 的等待,以及是否命中 page cache。
作业能正确读取数据、启动进程之后,才适合讨论它跑得有多快。下面先区分机器的理论计算规模和某个具体程序的端到端时间。
峰值性能与基准测试
峰值 FLOPS(floating-point operations per second,每秒浮点运算次数)由核心数、频率、向量宽度和每周期可完成的浮点操作估算。它描述机器在理想计算条件下的计算规模;应用程序的运行时间还要计入数据供给、同步、通信和 I/O。
HPL(High Performance Linpack,高性能 Linpack 基准)用密集线性方程组求解衡量浮点计算和网络协作能力。Netlib 将它定义为高密度线性代数工作负载。分析稀疏访问、小文件 I/O 或完整深度学习流程时,应选择访问模式更接近的基准。2
把一次程序运行拆开看会更具体。
总时间 = 计算 + 等待内存 + 等待通信/同步 + I/O + 运行时开销同一台机器可以在 HPL 上表现很好,却在某个数据密集型程序上速度普通。基准的访问模式、算术强度和并发方式应尽量接近要分析的应用。
计算、内存、网络与 I/O 瓶颈
处理器需要数据才能计算。数组扫描、网络传输和文件读取都要搬运字节,因此要先分清带宽和延迟。
- 带宽表示单位时间内可传输多少字节,例如 GB/s。
- 延迟表示一次请求从发出到最早得到结果需要多久,例如 ns 或 μs。
连续扫描一个很大的数组时,程序往往持续搬运数据,带宽更重要。链表遍历、小 MPI 消息和频繁打开文件会不断等待一次操作完成,延迟更显著。NERSC 使用 Roofline 模型把这类判断写成计算峰值和内存带宽上限之间的较小值。3
这里的 \(I\) 是算术强度,即浮点操作数除以从主存搬运的字节数;\(B_{\mathrm{memory}}\) 是可实现的内存带宽。公式给出的是上界。它的作用是帮助解释某段循环为什么更值得减少访存,还是更值得提高计算利用率。
延迟与带宽
MPI 通信常用下面的近似式估算。
其中 \(\alpha\) 是启动一次通信的固定延迟,\(n\) 是消息字节数,BW 是可用带宽,\(\beta=1/\mathrm{BW}\) 是每字节传输时间。真实运行还会受到网络拥塞、路由拓扑和集合通信算法影响。这个近似式适合区分两类常见问题:消息很小却发得很多时,优先减少轮次或合并消息;消息很大时,优先检查数据布局、带宽和能否与计算重叠。4
代入一组便于估算的数值。设启动延迟为 \(5\,\mu s\),可用带宽为 \(25\,\mathrm{GB/s}\)。
| 消息大小 | 带宽项 \(n/\mathrm{BW}\) | 估计总时间 |
|---|---|---|
| 1 KiB | 约 \(0.04\,\mu s\) | 约 \(5.04\,\mu s\) |
| 64 MiB | 约 \(2684\,\mu s\) | 约 \(2.69\,\mathrm{ms}\) |
1 KiB 消息的时间几乎由启动延迟决定。64 MiB 消息主要在搬运字节。程序若每一步发很多 1 KiB 消息,合并消息或减少同步轮数通常更有效;程序若一次传 64 MiB,数据布局、网络带宽和通信计算重叠更值得先测。
从时间线开始判断
多个 rank 运行变慢时,先看程序花在计算、同步、通信和读写上的时间。一个 barrier 前的等待也可能由负载不均或慢 I/O 引起,不能只把它当作网络问题。
指令集、编译器与微架构
ISA(instruction set architecture,指令集架构)规定程序可见的指令、寄存器和内存语义。微架构则决定同一条指令在某个处理器上怎样通过流水线、缓存和执行单元完成。
编译器选项中的 -march 会影响可使用的指令集,-mtune 会影响针对某类处理器的调度偏好。为较新的登录节点生成的二进制,未必能在较旧的计算节点运行。GCC 文档要求按目标机器和正确性需求选择优化选项;浮点重排也可能改变最后几位结果。11
先保留一个便于调试和验证的构建版本,再建立测性能的 Release 版本。修改优化选项后,同时比较数值误差和运行时间。
内存层级与虚拟内存
处理器通常先从缓存取数据,缓存未命中后再访问 DRAM。多插槽机器还会形成 NUMA(non-uniform memory access,非统一内存访问)结构:一个 CPU 插槽访问本地内存通常比访问另一个插槽的内存更快。
Linux 的内存策略文档说明,页面常在第一次实际访问时分配到某个 NUMA 节点。多线程程序若由一个线程初始化整个大数组,页面可能集中在那个线程所在的节点;随后其他节点的线程访问这些页面,就会产生远端访存。12
Cache 地址映射
缓存按固定大小的 cache line(缓存行)装入数据。连续访问更容易把一整行数据用完,也有利于硬件预取。某些周期性步长会让大量访问反复落到少数集合,形成冲突未命中;分块、改变 leading dimension(主维长度)或调整布局有时能缓解这一问题,仍需用测量确认。
内存分配与数据位置
为数组安排循环时,先看最内层访问的下标。C/C++ 的普通二维数组按行主序存放,最后一个下标连续;Fortran 默认按列主序存放,第一个下标连续。
/* C 的行主序数组中,j 连续。 */
for (int i = 0; i < m; ++i)
  for (int j = 0; j < n; ++j)
    sum += a[i][j];
这种布局选择常常比微调一条算术指令更早影响性能。多线程时,也应让每个线程先初始化、再处理自己负责的连续分块。
多核、线程和同步
共享内存并行需要先分配数据的读写责任。输入数组通常由多个线程共同读取;输出数组最好切成互不重叠的区域;求和、最大值等归约先在每个线程内计算局部结果,再合并。OpenMP 规范为这类归约和同步提供了直接表达方式。13
输入数组:多个线程可读
输出数组:按块分给一个线程写
归约变量:线程私有累加,最后合并
如果每次循环都进入 critical 区,线程会频繁排队。优先调整数据分块或使用 reduction,再讨论锁和原子操作。并行粒度也需要与工作量匹配:任务过小,调度和同步开销会超过计算;任务差异很大,静态分块又可能造成等待。
性能分析流程
性能优化建立在可复查的测量上。下面的顺序适合大多数课程实验。
- 选定正确性判据和有代表性的输入。
- 记录节点、模块、编译器、资源形状、线程绑定和命令。
- 测量端到端时间,确认时间主要花在哪个阶段。
- 再用 profiler 或硬件计数器解释热点受计算、内存、通信还是 I/O 限制。
- 一次修改一个因素,重复验证结果并保留原始数据。
作业脚本自测
一个 MPI+OpenMP 程序要在两个节点上运行,每节点 4 个 rank,每 rank 8 个线程。写出资源总量,并说明 --ntasks-per-node、--cpus-per-task 和 OMP_NUM_THREADS 应如何设置。
详细答案
每个节点需要 \(4\times8=32\) 个 CPU 配额。两个节点一共启动 8 个 MPI rank,并使用 64 个 CPU 配额。脚本中的关键部分可以写成:
#SBATCH --nodes=2
#SBATCH --ntasks-per-node=4
#SBATCH --cpus-per-task=8
export OMP_NUM_THREADS="$SLURM_CPUS_PER_TASK"
srun --cpu-bind=cores ./hybrid_solver
--ntasks-per-node=4 对应每节点 4 个 MPI rank。--cpus-per-task=8 给每个 rank 预留 8 个 CPU。OMP_NUM_THREADS=8 让一个 rank 内的 OpenMP 运行时也只创建 8 个工作线程。还需要确认分区中每个节点有足够 CPU,并查看实际日志,避免额外库线程造成过度订阅。
-
SchedMD, Slurm Workload Manager Overview, https://slurm.schedmd.com/overview.html. ↩↩↩
-
Netlib, HPL — A Portable Implementation of the High-Performance Linpack Benchmark, https://www.netlib.org/benchmark/hpl/. ↩
-
NERSC, Roofline Performance Model, https://docs.nersc.gov/tools/performance/roofline/. ↩
-
MPI Forum, MPI: A Message-Passing Interface Standard, https://www.mpi-forum.org/docs/. ↩
-
SchedMD, sbatch, https://slurm.schedmd.com/sbatch.html. ↩
-
SchedMD, srun, https://slurm.schedmd.com/srun.html. ↩
-
SchedMD, sacct, https://slurm.schedmd.com/sacct.html. ↩
-
TACC, Lmod User Guide, https://lmod.readthedocs.io/en/latest/010_user.html. ↩
-
Lustre, Lustre Documentation, https://doc.lustre.org/. ↩↩
-
NERSC, Checkpoint/Restart, https://docs.nersc.gov/development/checkpoint-restart/. ↩
-
GCC, Optimize Options, https://gcc.gnu.org/onlinedocs/gcc/Optimize-Options.html. ↩
-
Linux Kernel Documentation, NUMA Memory Policy, https://docs.kernel.org/admin-guide/mm/numa_memory_policy.html. ↩
-
OpenMP Architecture Review Board, OpenMP API Specification, https://www.openmp.org/specifications/. ↩
 本站总浏览