07-12 上午:OpenMP、C++ 线程与 MPI 并行计算基础
并行程序先要确定数据由谁读、由谁写,以及什么时候可以交给下一份工作。数据边界不同,程序会采用 OpenMP、C++ 线程或 MPI 等不同结构。
OpenMP(Open Multi-Processing,开放式多处理)让同一进程里的线程共同处理数组。MPI(Message Passing Interface,消息传递接口)让独立进程通过消息交换数据。C++ 标准库提供更底层的线程和同步工具。Lab 1 的 HPL(High Performance Linpack,高性能 Linpack 基准)使用 MPI;Lab 2 的 CPU kernel 会遇到线程与 SIMD;后续工作可将 MPI、OpenMP 和 GPU 组合起来。38
LLNL 并行计算教程的基本分类(译)
共享内存模型中的处理器可以访问同一地址空间。分布式内存模型中,每个处理器拥有本地内存,数据交换依靠网络消息。混合模型在节点内使用共享内存,在节点之间使用消息传递。4
先确定数据所有权
对每个数组记录下列三件事。rank 是 MPI 通信器中一个进程的编号。
- 谁初始化它
- 哪些线程或 rank 读取它
- 哪个执行单元写入哪一段
若无法说明一个输出元素由谁唯一写入,应先修正分解,再考虑 parallel for、锁或 MPI 调用。
三种并行边界
多个线程共享同一进程的数组和堆。适合单节点规则循环。需要明确私有变量、共享变量、归约和同步。
线程同样共享地址空间,但创建、任务队列、锁、条件变量和生命周期由程序负责。适合少量长期异步任务,不适合替代规则数组循环的 OpenMP。
每个 rank 是独立进程,普通变量不会自动共享。适合跨节点运行。数据分解、消息匹配和集合通信都必须显式表达。
一个节点内通常运行少量 MPI rank,每个 rank 启动 OpenMP 线程。资源申请、线程数、CPU 绑定和 NUMA 放置要与该层次一致。
并行分解方式
程序通常先按数据或工作来分。数据并行把向量、矩阵和网格切成多块;任务并行把不同性质的工作交给不同执行单元;流水并行让不同阶段同时处理不同批次。LLNL 的并行计算教程也把分解和数据依赖放在实现模型之前讨论,因为通信量和同步点由这里决定。4
| 分解 | 合适的对象 | 主要优点 | 需要额外检查 |
|---|---|---|---|
| 一维/二维数据块 | 向量、矩阵、图像、规则网格 | 输出易独占,访问连续 | 边界、负载、NUMA 位置 |
| 循环迭代 | 迭代独立的规则循环 | OpenMP 直接表达 | 数据竞争、调度策略 |
| 任务图 | 有明确依赖的子任务 | 可表达不规则并发 | 任务开销、关键路径 |
| 域分解 | 多节点网格/矩阵 | 可扩展到 MPI | halo 交换(相邻分区交换边界数据)、负载和通信量 |
| 流水线 | 多阶段处理 | 吞吐可重叠 | 队列、背压、阶段失衡 |
二维数组按行分给线程时,每个线程可连续写自己的行,通常有良好局部性。按棋盘格划分可能让边界更多、写入更分散。分解应从数据依赖图和热点访问方向推导。
线程开销与同步
创建或唤醒线程、从队列领取任务、进入 barrier(屏障)以及竞争锁都要花时间。若一个任务只做少量计算,运行时开销可能比计算本身还大。规则数组循环因此常复用一个线程团队,并给每个线程分配连续的工作块;在内层循环里反复创建 std::thread 或很小的 OpenMP 并行区,通常会放大这些开销。
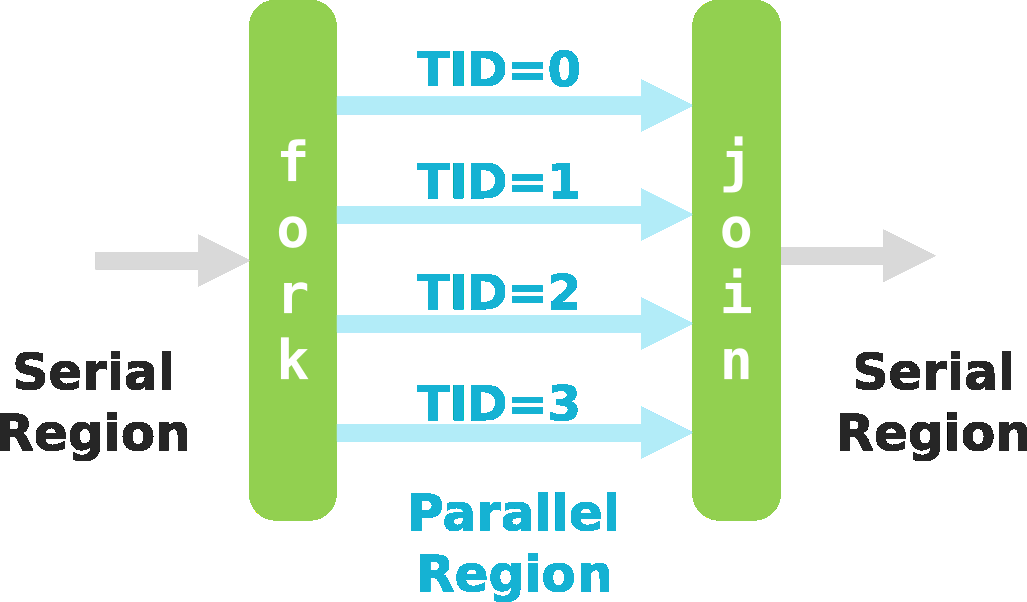
fork-join 描述并行区的生命周期。图中的 fork/join 是运行时组织线程团队的概念。3
同步应当对应一条明确的数据规则。多个线程分别算局部和、最后合成 sum 时,使用 reduction(归约)。只更新一个计数器时,atomic(原子更新)即可。一次操作需要同时检查并修改多个共享对象时,才需要互斥锁。critical 会让其中的代码一次只能由一个线程执行,应只包住真正互斥的部分。
OpenMP 的 fork-join 模型
OpenMP 程序起初只有一个初始线程。遇到 #pragma omp parallel 后,运行时组成一个线程团队;团队成员执行并行区,离开时再汇合。for、sections、single 和 task 分别描述团队内部不同的工作划分方式。OpenMP 规范允许编译器推断一部分变量属性;教学和性能敏感代码中,default(none) 可以要求程序员明确写出 shared、private、firstprivate 和 reduction。3
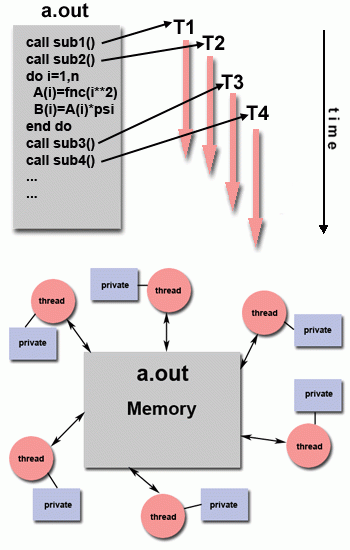
Lawrence Livermore National Laboratory 的 OpenMP Tutorial 展示共享变量和私有变量的边界。这个边界决定是否需要同步。1
#pragma omp parallel default(none) shared(x, y, n, a)
{
  #pragma omp for
  for (long i = 0; i < n; ++i)
    y[i] = a * x[i] + y[i];
}
i 在 worksharing-loop 中是私有循环变量;x/y/n/a 的作用域在上例中被明确声明。指针变量私有并不代表它指向的数组自动私有,数组的所有权仍需由程序逻辑定义。
parallel for、sections 与嵌套循环
规则循环首先使用 parallel for。sections 适合少数类型不同、数量固定的代码段,例如一个线程处理输入、另一个线程处理独立输出。嵌套规则循环通常先并行外层,以保持内层连续访问。外层迭代太少时才评估 collapse(2)。5
#pragma omp parallel for schedule(static)
for (int i = 0; i < m; ++i)
  for (int j = 0; j < n; ++j)
    c[i*n + j] = a[i*n + j] + b[i*n + j];
若写成 collapse(2),运行时把二维迭代空间线性化后划分。它可能改善外层很小时的负载,却也可能破坏“一个线程负责连续行”的数据位置;应在真实 shape 和线程数上测量。
static、dynamic 与 guided 调度
static 在循环开始时就分配迭代,开销很小,线程处理的数据位置也较稳定,适合矩阵加法和向量循环这类每轮代价接近的工作。dynamic 让空闲线程继续领取下一块,适合每轮成本差异很大的循环,但会增加队列和调度开销。guided 先分较大块,再逐渐减小块大小,可用于部分后段不均衡的工作。3
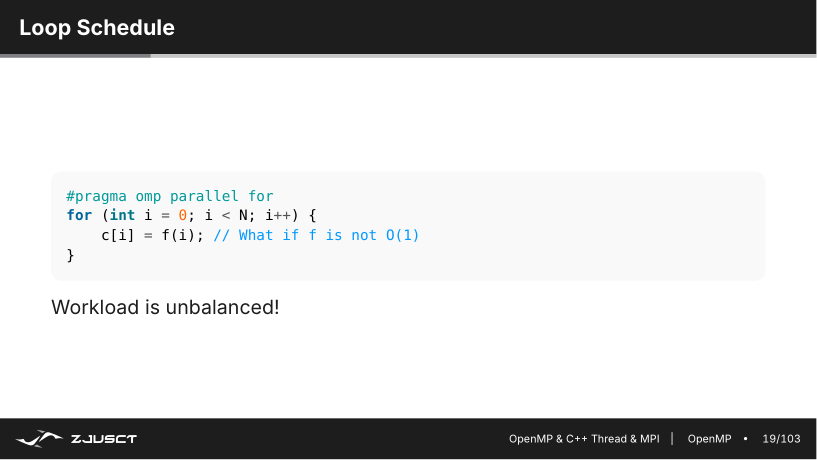
图中说明不均衡循环为何需要动态调度。数据局部性好、每轮成本接近时,static 通常更稳。
#pragma omp parallel for schedule(dynamic, 64)
for (long i = 0; i < n; ++i)
  work(items[i]);
选择 64 只是示例。应扫描若干 chunk 候选,记录时间和负载分布;如果 work(items[i]) 只做几条指令,先重排问题或增大任务粒度,而不是无限减小 chunk。
同步与归约
先看一个看似自然、实际有数据竞争的求和循环。
double sum = 0.0;
#pragma omp parallel for
for (long i = 0; i < n; ++i)
  sum += x[i];                 // 多个线程同时读写同一个 sum
sum += x[i] 不是一个不可分割的动作。线程 A 和线程 B 都可能先读到旧的 sum,各自完成加法后再写回;其中一次写入覆盖另一次写入,结果会随运行时序变化。给这行代码加 critical 可以得到正确结果,但每次迭代都要排队进入临界区,循环几乎重新串行化。
求和属于可结合的归约,OpenMP 可以为每个线程建立私有部分和,循环结束后再合并。
/* 每个线程先累加 local sum,运行时在循环后合并。 */
double sum = 0.0;
#pragma omp parallel for reduction(+:sum)
for (long i = 0; i < n; ++i)
  sum += x[i];

/* 单个计数器的读改写可使用更窄的原子更新。 */
#pragma omp atomic update
counter += 1;
critical 保护命名区域,一次只允许一个线程进入;atomic 保护受支持的单个内存更新,语义更窄、通常更轻;barrier 只等待团队成员到达,不传输数据也不修复竞态;reduction 把合并模式交给运行时。浮点 reduction 会改变加法树,不能假定与串行逐位一致。3
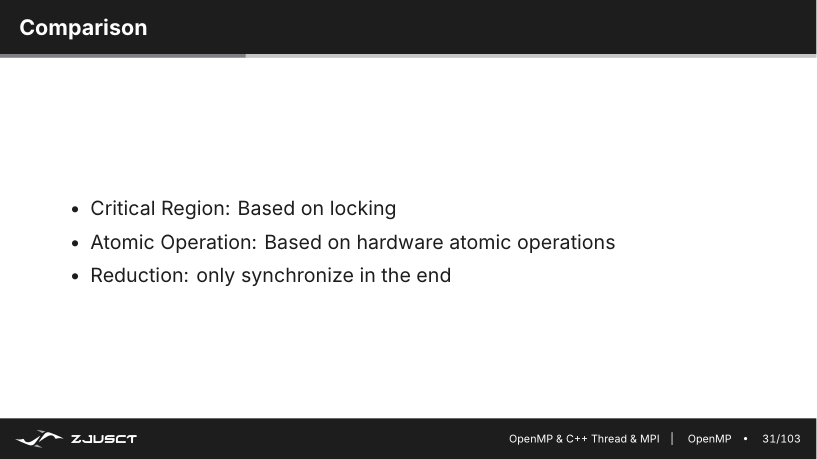
选择依据是数据依赖。输出可以按线程独占时,三者都不应位于每次迭代的热路径。6
缓存与数据所有权
线程分别写相邻小变量时,逻辑上互不冲突,物理上仍可能共享同一缓存行,造成 false sharing(伪共享)。局部累加器应尽量保存在线程私有变量中,循环结束后再 reduction;数组输出应按连续块划分,避免多个线程交错写相邻元素。绑定策略和 NUMA first-touch(由首次写入线程影响页位置)见前面的系统与性能分析页面。
C++ 线程与线程池
std::thread 创建一个独立执行流。它与其他线程共享进程的地址空间和打开的文件,但每个线程有自己的执行状态。join() 表示等待该线程结束并回收其资源。未处理异常、访问已经释放的对象、遗漏 join() 都会造成生命周期问题。
共享状态要通过 std::mutex、std::lock_guard、std::condition_variable 或 std::atomic 表达同步。mutex 是互斥锁;lock_guard 让锁在离开当前作用域时自动释放;condition_variable 用于等待某个条件成立;atomic 用于支持的单个原子读改写。C++ 所说的数据竞争,是多个线程同时访问同一内存位置,其中至少一个访问是写,且程序没有提供满足语言内存模型的同步。这样的程序不能依靠某次机器上的偶然执行顺序来判断正确性。7
std::mutex m;
long total = 0;

void add_range(const int* a, int begin, int end) {
  long local = 0;
  for (int i = begin; i < end; ++i) local += a[i];
  std::lock_guard<std::mutex> lock(m);
  total += local;
}
这里锁只用于最后一次合并,热点循环使用局部变量。若每次 local += a[i] 都改为加锁,所有线程会在同一锁上排队。
条件变量与任务队列
条件变量适合“队列为空时睡眠,有新任务时唤醒”的场景。等待必须在谓词循环中进行。谓词就是“队列是否非空且尚未关闭”这类可检查条件;虚假唤醒指线程被唤醒时条件实际仍不成立,也可能在重新获得锁前被其他线程抢走任务。线程池需要定义队列关闭、异常传播、未完成任务和对象销毁的语义;课程中的规则数值循环通常更适合 OpenMP,而非手写线程池。7
下面的图将线程池的长期工作线程、共享队列和任务领取过程放在一起。它解释的是线程生命周期和任务分配,任务之间的数据依赖仍需要由程序设计表达。
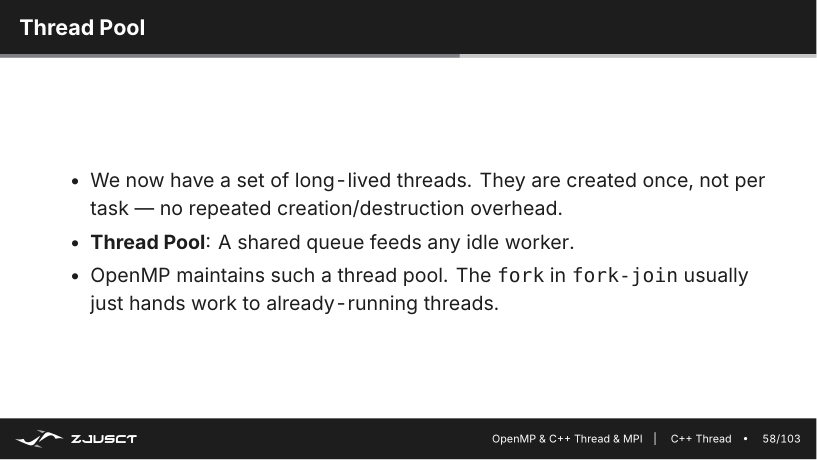
线程池处理任务生命周期与创建开销。任务依赖、共享写入和负载不均仍需算法和程序结构处理。
MPI 中每个进程有独立地址空间
MPI 中每个 rank 是独立进程;rank 是 MPI 通信器内一个进程的编号,不同 rank 不共享普通变量。有自己的堆、全局变量和文件描述符。MPI_COMM_WORLD 是常用通信器,MPI_Comm_rank 给出当前 rank 编号,MPI_Comm_size 给出通信器大小。只有通过 MPI 通信调用,数据才会从一个 rank 到另一个 rank;这也是 MPI 可以跨节点运行的原因。8
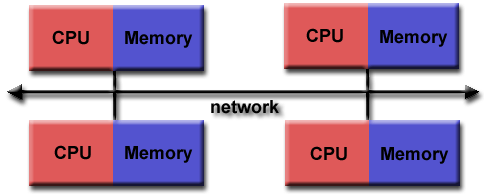
Lawrence Livermore National Laboratory 的 MPI Tutorial 展示 MPI 的数据边界。数据边界由进程和消息接口明确划分。2
MPI_Init(&argc, &argv);
int rank, size;
MPI_Comm_rank(MPI_COMM_WORLD, &rank);
MPI_Comm_size(MPI_COMM_WORLD, &size);
/* 每个 rank 只计算自己拥有的数据段。 */
MPI_Finalize();
点对点通信、匹配与死锁
一条 MPI 消息需要按通信器、源 rank、目标 rank、tag、数据类型和数量等信息匹配。接收方可指定来源和 tag,也可以使用 MPI_ANY_SOURCE、MPI_ANY_TAG;调试阶段若过度使用通配符,消息顺序错误更难定位。发送尚未完成时不能改写发送缓冲区,接收尚未完成时也不能使用接收结果。8
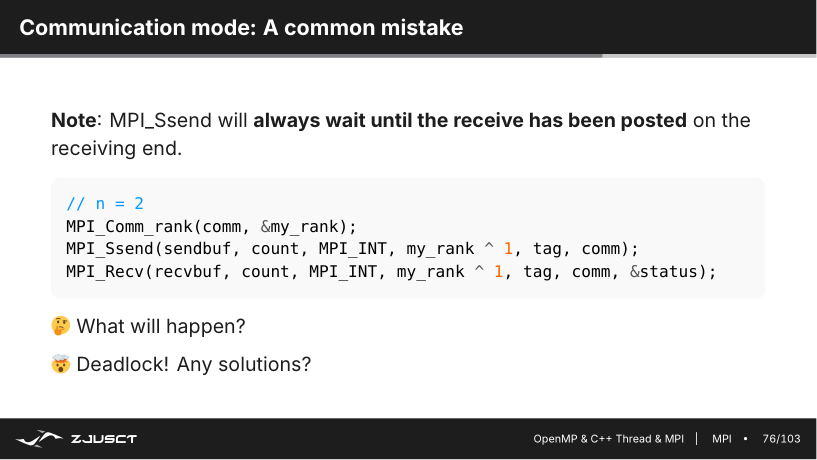
这是同步发送导致的确定性死锁。普通 MPI_Send 是否因内部缓冲暂时返回取决于实现和消息大小。
MPI_Sendrecv 是交换邻居数据的直接选择。需要重叠通信和计算时,先张贴接收,再启动发送,期间计算与通信无关的部分,最后在真正使用边界数据前 MPI_Waitall。
MPI_Request req[2];
MPI_Irecv(recvbuf, n, MPI_DOUBLE, left,  0, MPI_COMM_WORLD, &req[0]);
MPI_Isend(sendbuf, n, MPI_DOUBLE, right, 0, MPI_COMM_WORLD, &req[1]);
compute_interior();
MPI_Waitall(2, req, MPI_STATUSES_IGNORE);
compute_boundary(recvbuf);
下面的图补充这段代码中的生命周期。请求对象返回后,发送缓冲区和接收缓冲区仍分别有自己的使用限制,直到等待操作确认通信完成。
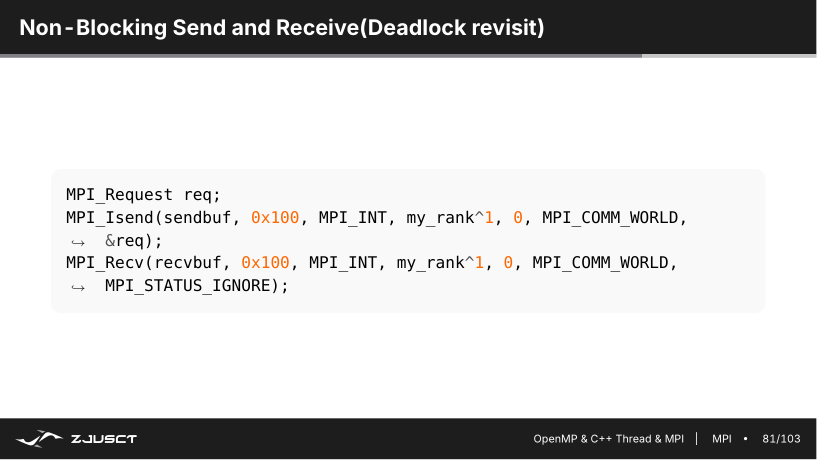
非阻塞调用创造重叠机会。没有可独立计算,或网络和内存资源不足时,Waitall 仍可能几乎等待全部通信时间。
集合通信把共同模式交给 MPI 库
广播、散布、聚集、规约和全体规约都属于集合通信,也就是通信器内一组 rank 必须共同参与的操作。MPI 库可按进程数、网络拓扑和消息尺寸选择树形、环形或其他实现,通常比手工拼写大量点对点消息更容易检查。MPI_Bcast 把共同输入发给所有 rank;MPI_Reduce 在 root 汇总局部结果;MPI_Allreduce 则让每个 rank 都得到同一份汇总值。9
MPI_Allreduce(&local_norm, &global_norm, 1,
              MPI_DOUBLE, MPI_SUM, MPI_COMM_WORLD);
所有参与 rank 必须以兼容顺序调用同一个集合操作。若一个 rank 跳过 MPI_Bcast 而另一个进入它,程序通常会挂起;MPI_Barrier 也只是等待点,不会传输应用数据或完成其他集合操作。
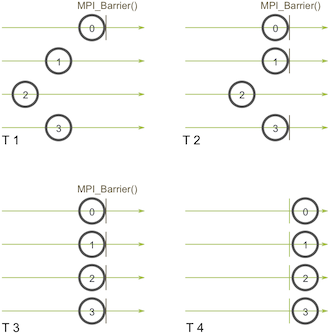
barrier 用于表达必须等待的阶段边界。过多 barrier 会把负载不均直接变成空等。
MPI 与 OpenMP 混合并行
混合并行通常在节点间使用 MPI、节点内使用 OpenMP。资源形状必须一致。--ntasks-per-node 指每节点 rank 数,--cpus-per-task 指每个 rank 可用 CPU 数,OMP_NUM_THREADS 通常与后者相等。每个 rank 又启动整机核心数线程时,会出现过度订阅,即运行线程数超过调度器分配的 CPU 配额,从而扰动缓存、NUMA 和调度稳定性。10
#SBATCH --nodes=2
#SBATCH --ntasks-per-node=4
#SBATCH --cpus-per-task=8
export OMP_NUM_THREADS="$SLURM_CPUS_PER_TASK"
srun --cpu-bind=cores ./hybrid_solver
一个常见起点是每个 NUMA 域一个 rank,rank 内线程绑定到本地核心并 first-touch 自己的数据块。first-touch 指物理页通常由首次写入它的线程所在 NUMA 节点分配。这个布局仍要结合节点拓扑、通信模式和热点是否受内存带宽限制来验证。
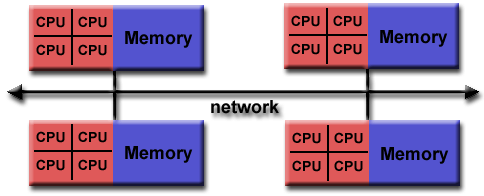
Lawrence Livermore National Laboratory 的 MPI Tutorial 展示 MPI + OpenMP 的常见形式,即节点间消息传递、节点内共享内存并行。2
从问题分解到框架选择
框架选择由数据边界和工作形状决定。单节点上的规则数组循环通常从 OpenMP parallel for 开始。数据跨节点分布且需要显式交换时,使用 MPI。少量长期运行的异步活动可使用 C++ 线程。工作之间有复杂依赖时,先画任务图,再评估 OpenMP task 或专门运行时。11
SHA-512 并行案例
对许多独立文件求 SHA-512 时,每个文件是独立任务,可按文件分配给线程或 rank。标准连续消息摘要的内部状态按块链式更新。并行树形哈希需要选择定义了这种组合语义的算法。这个例子说明输入能切块,仍需确认原问题是否可直接并行。
任务依赖与粒度
任务图中节点是工作,边是必须先后完成的依赖。某时刻可执行节点数给出可用并行度,最长依赖链给出关键路径。任务太细时队列、同步和缓存扰动占比高。任务太粗时可用并行度不足。测量不同粒度下的执行时间与负载,才能判断运行时开销是否值得。11
并行框架选择
| 问题特征 | 起始方案 | 要验证的风险 |
|---|---|---|
| 单节点、规则数组循环 | OpenMP parallel for |
迭代独立、调度、false sharing |
| 单节点、少量长期并发活动 | C++ 线程 | 生命周期、锁、条件变量和异常 |
| 多节点、显式域分解 | MPI | 消息匹配、死锁、通信/计算重叠 |
| 多节点且节点内算力强 | MPI + OpenMP | rank/线程布局、NUMA、过度订阅 |
从资源到程序的自测
获得 2 个节点,每节点 4 个 MPI rank,每个 rank 8 个 OpenMP 线程。作业脚本、环境变量和代码中分别应保证什么?
详细答案
作业一共需要 8 个 MPI rank,每个节点需要 \(4\times8=32\) 个 CPU 线程配额。脚本、环境和代码需要表达同一层次。
#SBATCH --nodes=2
#SBATCH --ntasks-per-node=4
#SBATCH --cpus-per-task=8
export OMP_NUM_THREADS="$SLURM_CPUS_PER_TASK"
srun --cpu-bind=cores ./hybrid_solver
每个 rank 只创建 8 个 OpenMP 线程。rank 之间通过 MPI 交换数据。同一 rank 内的线程共享本 rank 的地址空间。还应记录 CPU 绑定和 NUMA 策略,并检查 srun 实际启动的 rank 数、线程数和节点列表,避免 rank 或线程超过申请资源。
-
Lawrence Livermore National Laboratory, OpenMP Tutorial, https://hpc-tutorials.llnl.gov/openmp/. ↩
-
Lawrence Livermore National Laboratory, MPI Tutorial, https://hpc-tutorials.llnl.gov/mpi/. ↩↩
-
OpenMP Architecture Review Board, OpenMP API Specification, https://www.openmp.org/specifications/. ↩↩↩↩↩
-
Lawrence Livermore National Laboratory, Introduction to Parallel Computing Tutorial, https://hpc.llnl.gov/documentation/tutorials/introduction-parallel-computing-tutorial. ↩↩
-
OpenMP Architecture Review Board, OpenMP Examples, https://www.openmp.org/resources/openmp-examples/. ↩
-
ISO C++ Foundation, C++ reference: thread support library, https://en.cppreference.com/w/cpp/thread. ↩↩
-
MPI Forum, MPI Standard Documents, https://www.mpi-forum.org/docs/. ↩↩↩
-
Open MPI, MPI Collectives, https://docs.open-mpi.org/en/main/man-openmpi/man3/MPI_Bcast.3.html. ↩
-
Open MPI, Process placement and binding, https://docs.open-mpi.org/en/main/launching-apps/scheduling.html. ↩
-
OpenMP Architecture Review Board, OpenMP 5.2 Tasking, https://www.openmp.org/spec-html/5.2/openmpse83.html. ↩↩
 本站总浏览